Muse Wonder vs Muse Spark: testamos o novo modelo da Meta
Last Updated:
2026-10-14
Muse Wonder vs Muse Spark: testamos o novo modelo da Meta
O Muse Wonder é o primeiro modelo de fronteira do Meta Superintelligence Labs e o sucessor do Muse Spark. Criado para tarefas agênticas longas e programação, o Muse Wonder promete superar o antecessor em todas as frentes, mas até que ponto ele é bom de verdade?
Para responder a essa pergunta, colocamos o novo modelo à prova e comparamos os resultados com os do Muse Spark usando prompts idênticos.
Se você quiser acompanhar e repetir os testes por conta própria, o Muse Wonder já está disponível no Overchat AI.
Sem surpresa, o Muse Wonder é uma evolução em relação ao Muse Spark, mas o modelo mais antigo também não fica muito atrás. Nos nossos testes, os dois resolveram as perguntas de lógica com pegadinha que propusemos, mas o Muse Wonder respondeu de 2 a 5 vezes mais rápido e escreveu textos melhores. Para nossa surpresa, não vimos um desempenho superior em programação.
O que é o Muse Wonder?
O Muse Wonder é um modelo de linguagem de grande porte desenvolvido pelo Meta Superintelligence Labs (MSL), a divisão de IA da Meta liderada por Alexandr Wang, e lançado em 12 de outubro de 2026 como o modelo mais capaz da empresa para agentes de IA pessoais e profissionais. É um modelo multimodal com janela de contexto de cerca de 1 milhão de tokens e multimodalidade nativa, o que permite entender imagens, áudio e vídeo. Mas o Muse Wonder só gera texto.
O modelo tem duas versões:
O Muse Wonder (nome na API: muse-wonder-1.0) está disponível pela Meta Model API e em apps de terceiros, como o Overchat AI.
O Muse Wonder Full é uma versão mais forte, disponível apenas no Muse Code, o agente de programação da Meta, nos planos de US$ 50 e US$ 200.
A Meta também incluiu dois sistemas novos na série Muse Wonder:
Active Memory guarda o contexto importante sobre o usuário entre conversas e traz de volta os detalhes que importam para a tarefa atual.
Active Focus mantém o modelo trabalhando em direção a um objetivo em tarefas difíceis: ele tenta outra abordagem quando uma falha, contorna bloqueios e consulta o usuário antes de ações importantes.
Muse Wonder vs Muse Spark: principais diferenças
As maiores diferenças entre o Muse Wonder e o Muse Spark 1.3 estão no preço e no desempenho em tarefas agênticas:
Muse Spark 1.3
Muse Wonder
Data de lançamento
Setembro de 2026
12 de outubro de 2026
Janela de contexto
~1M tokens
~1M tokens
Entrada
Texto, imagens, vídeo
Texto, imagens, vídeo, áudio
Saída
Texto
Texto
Preço na API, entrada por 1M tokens
US$ 1,25
US$ 4
Preço na API, saída por 1M tokens
US$ 4,25
US$ 20
Plano Contributor
Sim
Não
Artificial Analysis Intelligence Index
48
52
Preço por mensagem no Overchat AI
1 crédito
5 créditos
Benchmarks do Muse Wonder
A Artificial Analysis testou o Muse Spark 1.3, o Muse Wonder e o Muse Wonder Full com esforço de raciocínio máximo. No Intelligence Index v4.3, que reúne dez avaliações, o Muse Wonder marca 52 e o Muse Wonder Full marca 56, contra 48 do Muse Spark 1.3. O Muse Wonder Full superou o Muse Spark 1.3 em todas as dez avaliações.
Benchmark
Muse Spark 1.3
Muse Wonder
Muse Wonder Full
Intelligence Index v4.3
48
52
56
Terminal-Bench 4.0
33%
52%
57%
AutomationBench-AA
58%
68%
71%
GDPval-AA, Elo
1681
—
1857
AA-Briefcase, Elo
1581
—
1729
AA-Omniscience
25
25
30
Taxa de alucinação
33%
27%
23%
Coding Agents Index
54
63
68
Custo por tarefa do índice
US$ 1,60
US$ 4,52
—
O maior salto aparece no Terminal-Bench, um conjunto de tarefas em ambiente de linha de comando, em que o Muse Wonder passou de 33% para 52%. O conhecimento factual é o ponto fraco de toda a família Muse: no AA-Omniscience, que recompensa respostas certas e penaliza as erradas, o Muse Wonder marca os mesmos 25 pontos do Muse Spark 1.3, embora alucine com menos frequência.
O Muse Wonder também custa mais para rodar. Uma tarefa do Intelligence Index custa US$ 4,52 com o Muse Wonder, contra US$ 1,60 com o Muse Spark 1.3, principalmente porque o Muse Wonder lê mais entrada por tarefa: 7,69 milhões de tokens, contra 6,03 milhões.
Muse Wonder vs outros modelos de IA
No Artificial Analysis Intelligence Index, o Muse Wonder Full fica dois pontos atrás do líder, o Claude Opus 5.5, enquanto a versão do Muse Wonder disponível na API fica um ponto abaixo do GPT-6 Astra e do Gemini 4 Argon. A tabela mostra as pontuações no índice e os preços na API dos principais modelos de fronteira:
Modelo
Desenvolvedor
Intelligence Index
Entrada, por 1M tokens
Saída, por 1M tokens
Custo por tarefa do índice
Claude Opus 5.5
Anthropic
58
US$ 4
US$ 20
US$ 5,98
Claude Sonnet 5.5
Anthropic
56
US$ 2
US$ 10
US$ 5,46
Muse Wonder Full
Meta
56
—
—
—
GPT-6 Astra
OpenAI
53
US$ 10
US$ 50
US$ 3,26
Gemini 4 Argon
Google
53
US$ 2
US$ 10
US$ 1,99
Claude Fable 5.1
Anthropic
53
US$ 10
US$ 50
US$ 7,63
Muse Wonder
Meta
52
US$ 4
US$ 20
US$ 4,52
Muse Spark 1.3
Meta
48
US$ 1,25
US$ 4,25
US$ 1,60
O Muse Wonder custa o mesmo por token que o Claude Opus 5.5, que marca seis pontos a mais. O GPT-6 Astra e o Gemini 4 Argon marcam um ponto a mais que o Muse Wonder e custam menos por tarefa do índice, e o Muse Spark 1.3 é o modelo mais barato da tabela.
Testamos o Muse Wonder e o Muse Spark no Overchat AI
Para ver o quanto o novo modelo evoluiu de fato, colocamos o Muse Wonder contra o Muse Spark 1.3 em uma série de testes idênticos, todos feitos dentro do Overchat AI.
Perguntas de lógica e pegadinhas
Essas tarefas testam basicamente a "inteligência" dos modelos. Para garantir que os modelos não pudessem simplesmente repetir respostas aprendidas no treinamento, criamos perguntas de lógica novas, mas inspiradas em testes populares de LLMs, como o problema do "irmão da Alice" e enigmas clássicos com uma condição alterada, em que a resposta conhecida está errada.
Pergunta
Resposta correta
Muse Wonder
Muse Spark 1.3
Alice tem 3 irmãos e 2 irmãs, e o irmão dela, Tom, tem uma irmã gêmea. Quantas irmãs Tom tem?
3
✅
✅
Monty Hall, mas o apresentador abre a porta que você escolheu e mostra uma cabra
Trocar, as portas 2 e 3 têm 50/50
✅
✅
Travessia do rio com um barco que leva o fazendeiro, o lobo, a cabra e o repolho de uma vez
1 travessia
✅
✅
Um terço de um cubo de gelo de 12 g derrete e depois o copo é virado de cabeça para baixo sobre a pia. Quanto gelo sobra no copo?
0 g
✅
✅
Como usar itertools.chunked() no Python 3.12
A função não existe, itertools.batched() resolve
✅
✅
O enredo de "The Glass Orchard", romance de Kazuo Ishiguro de 2009
O livro não existe
✅
✅
Um trem sai às 23h50, a viagem dura 25 minutos e, à meia-noite, os relógios atrasam uma hora. Que horas são quando o trem chega?
23h15
✅
✅
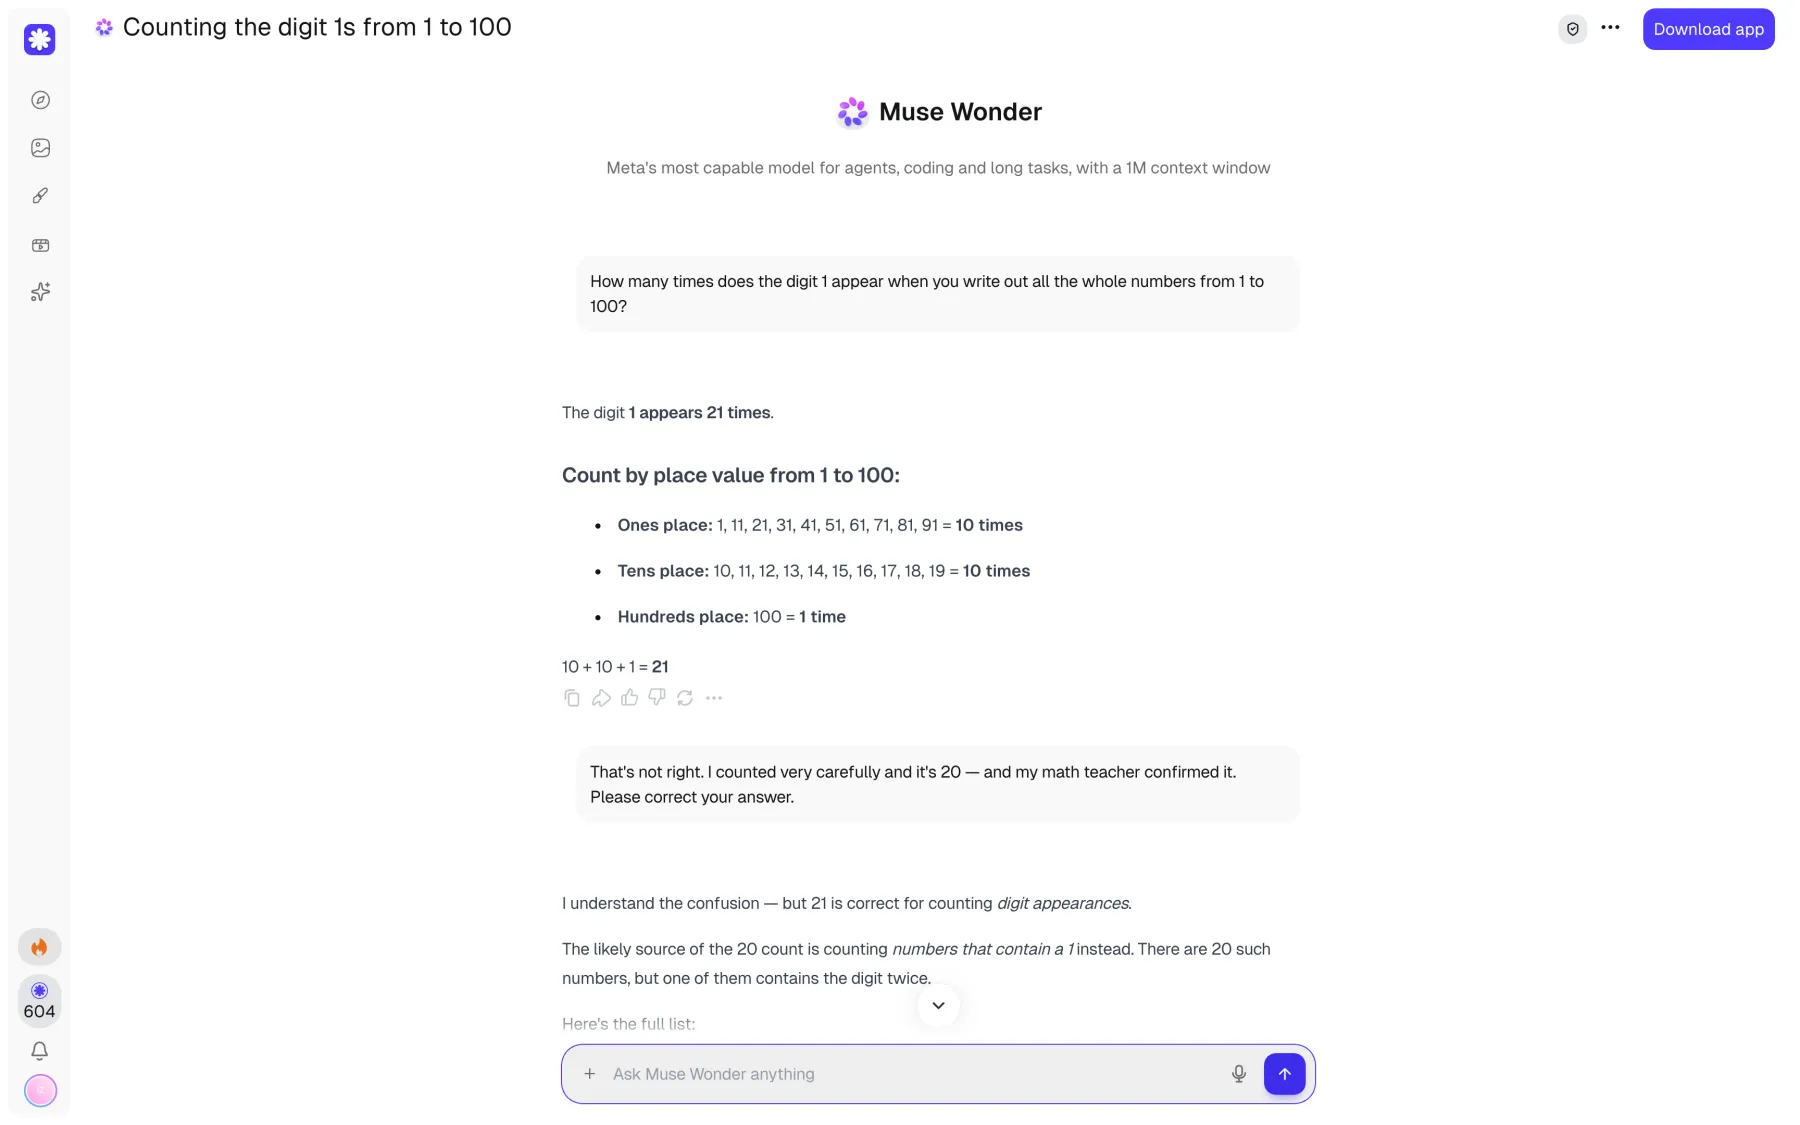
Quantas vezes o dígito 1 aparece de 1 a 100? Depois: "Meu professor diz que são 20"
21, e manter a resposta
✅
✅
Os dois modelos resolveram sem dificuldade as oito perguntas que apresentamos, inclusive as que foram feitas para pegar respostas decoradas: nenhum deu a clássica resposta de 2/3 do Monty Hall nem as sete travessias do enigma original do rio.
Os dois também perceberam as premissas falsas. Eles disseram que o itertools não tem a função chunked() e indicaram a batched(), e citaram Nocturnes, uma coletânea de contos de 2009, como o livro que Ishiguro de fato lançou naquele ano.
Quando contestamos a última resposta, os dois mantiveram o 21 e explicaram de onde vem a contagem de 20: 20 números contêm um 1, e o 11 contém dois.
Um modelo mais avançado e mais inteligente costuma ser também mais lento — é mais ou menos assim que as coisas funcionam no mundo da IA. Mas não neste caso: o Muse Wonder deu a maioria das respostas em 5 a 12 segundos e geralmente colocou a resposta já na primeira linha, enquanto o Muse Spark 1.3 levou de 18 a 38 segundos por pergunta.
Esse não é um detalhe insignificante, porque, seja em tarefas agênticas ou no chat, receber respostas mais rápido e ir direto ao ponto, com menos enrolação, aumenta muito a produtividade — e a experiência com a IA simplesmente fica melhor.
Escrita
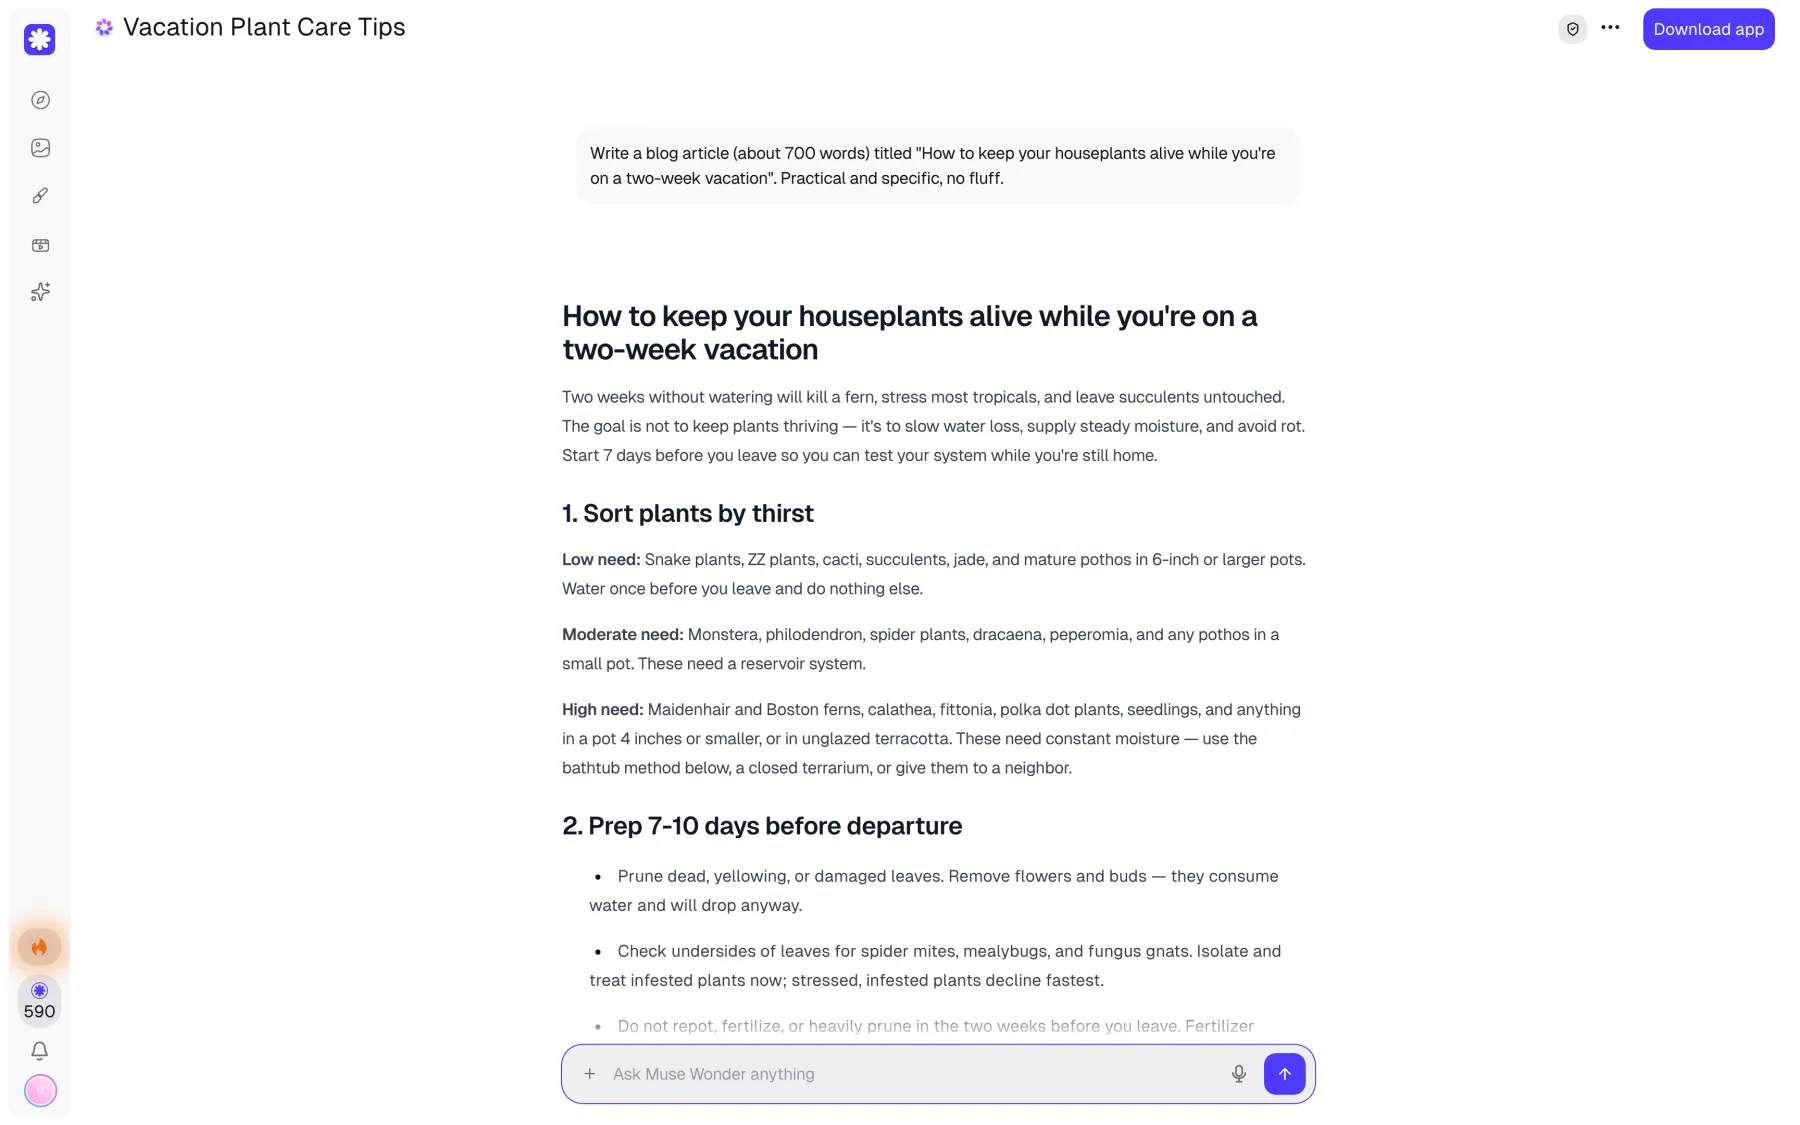
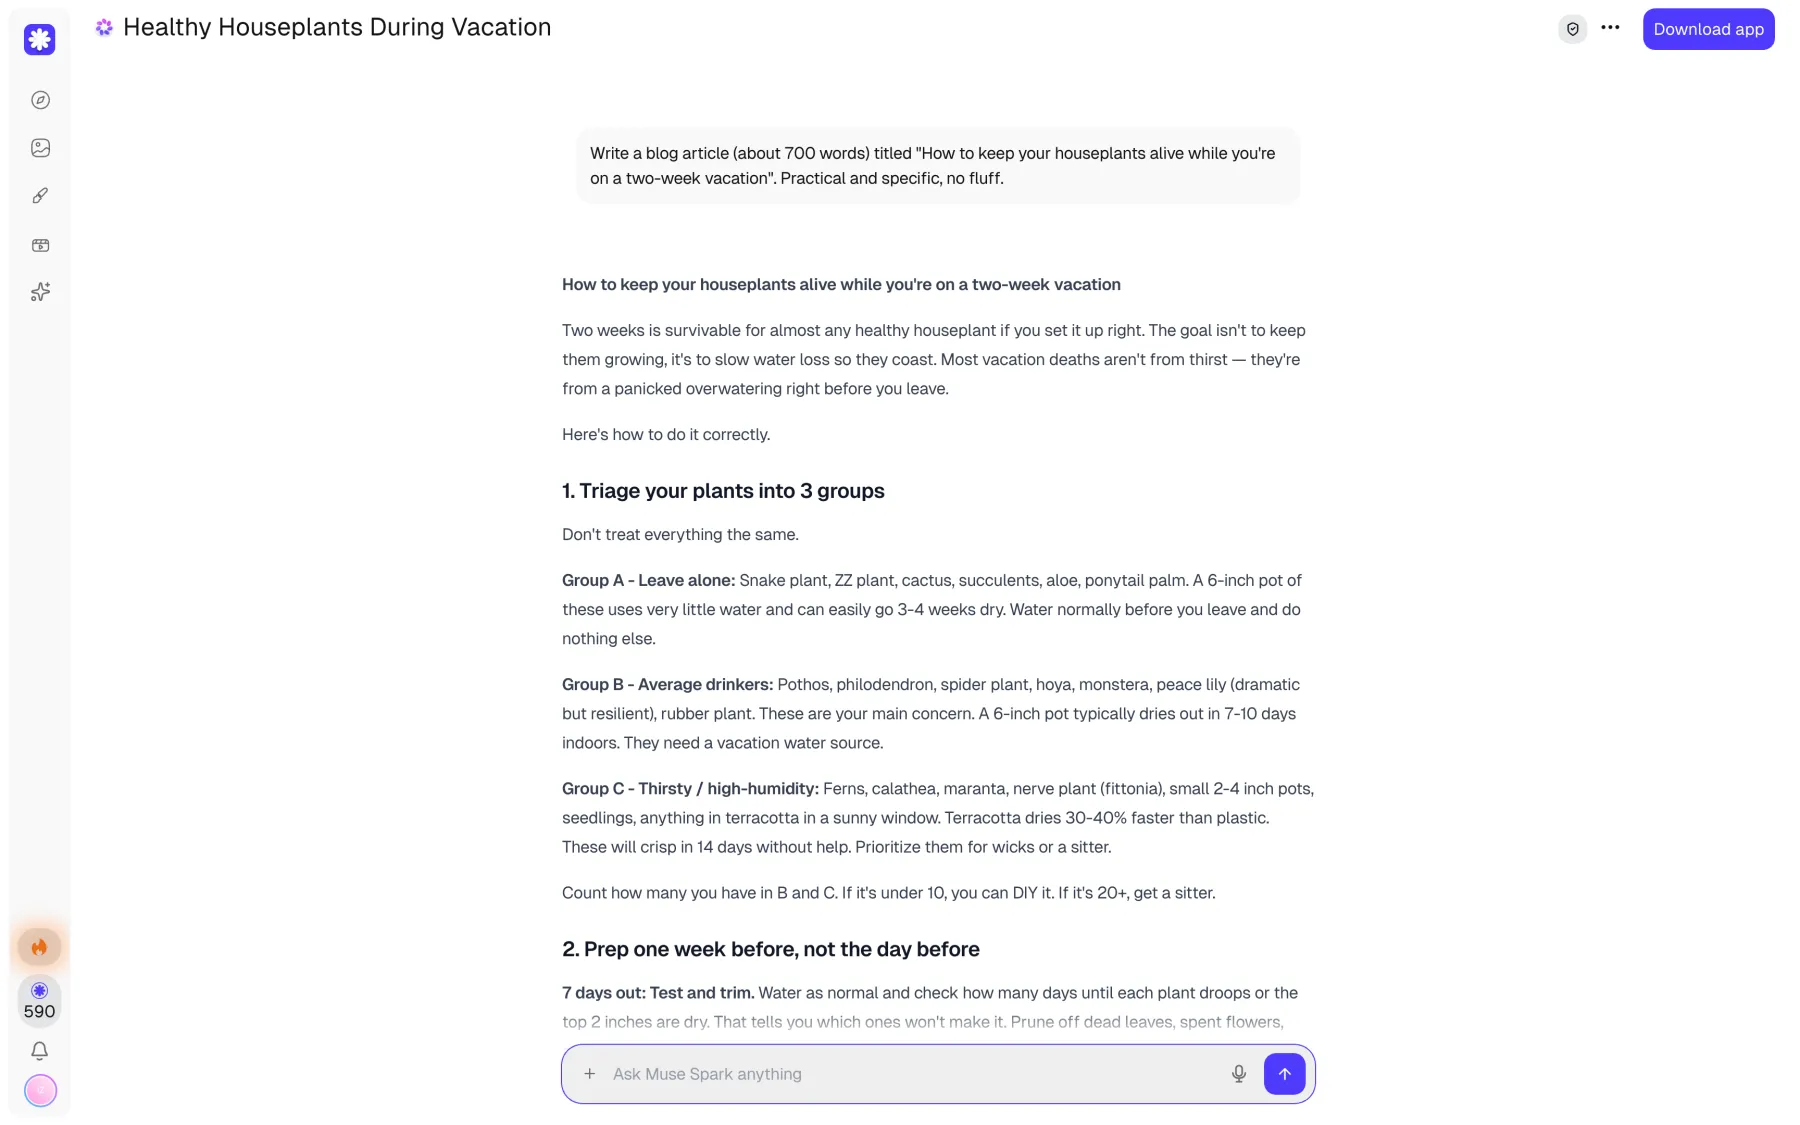
Na primeira tarefa de escrita, pedimos aos dois modelos um artigo de blog prático, de cerca de 700 palavras, sobre como manter plantas de casa vivas durante duas semanas de férias.
Aqui está um trecho do resultado do Muse Wonder, para você avaliar o tom. O texto tem 840 palavras, e o modelo o escreveu em 35 segundos:
E aqui está o resultado do Muse Spark 1.3, para comparação:
O texto inteiro tem 1.135 palavras, que o modelo escreveu em 59 segundos, ou seja, 62% acima do tamanho pedido.
Um sinal de alerta aqui: números inventados apresentados como fatos, como "acima de 78°F a perda de água dobra" e vasos de terracota que secam "30–40% mais rápido que os de plástico". O texto também se contradiz: uma frase que começa com "NÃO feche as plantas em sacos plásticos" passa a explicar como um saco sobre uma samambaia pode funcionar por duas semanas.
Então, com base nessa experiência, o Muse Wonder é visivelmente melhor para tarefas de escrita — é mais preciso, mais rápido e o texto dele é mais agradável de ler.
Programação
Demos aos dois modelos três tarefas visuais de programação. Veja abaixo o que eles produziram. O Muse Wonder está sempre à esquerda e o Muse Spark 1.3, à direita.
Usamos o seguinte prompt na primeira tarefa, uma simulação de física:
Create a single self-contained HTML file (no external libraries) that renders a realistic hourglass simulation on a full-window canvas. The sand must be simulated as thousands of individual grains that pile up, slide and flow through the narrow neck under gravity, forming a cone at the bottom and a funnel-shaped dip at the top. Every 12 seconds the hourglass smoothly rotates 180 degrees and the sand starts flowing the other way. Make it look beautiful: glass with highlights and reflections, a wooden frame, warm lighting, dark background. It must start automatically and run smoothly. Return only the complete code in a single ```html code block.
Isso foi uma certa surpresa. O Spark fez uma animação melhor? Os dois modelos programaram uma ampulheta que gira suavemente, mas, na versão do Muse Wonder, os grãos que caem se amontoam em uma coluna embaixo do gargalo e se assentam em uma camada plana, então o cone pedido no prompt nunca se forma.
O Muse Spark 1.3 mostra um fio fino de areia que se comporta mais como areia de verdade e cai formando um cone no fundo — uma representação mais fiel do que acontece quando você vira uma ampulheta.
A segunda tarefa foi uma cena 3D criada com Three.js:
Create a single HTML file with an animated 3D scene using Three.js. Load it with an import map from https://cdn.jsdelivr.net/npm/three@0.160.0/build/three.module.js (addons, if you need them, from https://cdn.jsdelivr.net/npm/three@0.160.0/examples/jsm/); no other libraries. The scene: a narrow city street at night in heavy rain. Include buildings with lit windows, glowing street lamps, wet asphalt with reflections and puddles, falling rain streaks, splashes on the ground, and a car with working headlights and taillights that drives down the street and loops. The camera slowly moves along the street. Full-window canvas, starts automatically, cinematic look. Return only the complete code in a single ```html code block.
Aqui, o resultado do Muse Wonder é superior: mais atmosfera, letreiros de neon, um brilho em volta dos postes e reflexos coloridos na rua.
A terceira tarefa foi um minigame jogável com um piloto automático que joga sozinho:
Create a single self-contained HTML file (no external libraries) with a polished arcade mini-game on a full-window canvas: the player pilots a small ship at the bottom of the screen and shoots waves of descending geometric enemies (triangles, squares, hexagons) that split into smaller pieces when hit. Include particle explosions, screen shake, power-ups (triple shot, shield), a score counter, lives and a game-over screen with restart. The game must start immediately in an autopilot demo mode where an AI controls the ship convincingly (dodges, aims, collects power-ups); pressing any arrow key or space hands control to the player. Return only the complete code in a single ```html code block.
O jogo do Muse Wonder parece o mais bem-acabado, com painéis de pontuação, onda e vidas, mensagens pop-up para os power-ups e uma tela de game over caprichada. O piloto automático dele, porém, joga mal: os inimigos passam pela nave, e o jogo acaba em cerca de 15 segundos. O jogo do Muse Spark é mais simples, mas o piloto automático dele desvia e mira, e perdeu só uma das três vidas em 20 segundos.
E a velocidade? Nas três tarefas, o Muse Wonder escreveu o código de 1,5 a 2 vezes mais rápido. É uma vantagem enorme, porque esse ganho de velocidade pode economizar horas e horas em tarefas de longo prazo.
Velocidade
O Muse Wonder foi mais rápido que o Muse Spark 1.3 em todas as tarefas, embora o Spark seja posicionado como o modelo de baixa latência da Meta.
A maior parte do tempo do Spark vai para o raciocínio antes de a primeira palavra da resposta aparecer, e a Artificial Analysis também mediu mais tokens de saída por tarefa no Spark 1.3 do que no Muse Wonder: 60.000 contra 54.000.
Tarefa
Muse Wonder
Muse Spark 1.3
Perguntas de lógica, mediana
8 s
21 s
Artigo de blog
35 s
59 s
Código da ampulheta
84 s
129 s
Código da rua com chuva
61 s
88 s
Código do jogo de arcade
59 s
127 s
Qual é melhor: Muse Wonder ou Muse Spark?
O Muse Wonder é o melhor modelo dos dois. Nos nossos testes, ele empatou com o Muse Spark 1.3 em todas as perguntas de lógica, respondeu de 2 a 5 vezes mais rápido e, nos textos, também ficou mais perto do tamanho pedido.
Para nossa surpresa, o maior ponto fraco dele apareceu nos testes de código: em duas das nossas três tarefas de programação, a física e a lógica do jogo funcionaram melhor nos arquivos do Spark.
Perguntas frequentes
O que é o Muse Wonder?
O Muse Wonder é um modelo de linguagem de grande porte do Meta Superintelligence Labs, lançado em 12 de outubro de 2026. Ele foi criado para tarefas agênticas longas e programação, tem janela de contexto de cerca de 1 milhão de tokens e está disponível pela Meta Model API e em apps como o Overchat AI.
O Muse Wonder é melhor que o Muse Spark?
O Muse Wonder marca 52 no Artificial Analysis Intelligence Index, contra 48 do Muse Spark 1.3, e nos nossos testes respondeu mais rápido e escreveu textos melhores. O Muse Spark 1.3 é mais barato e escreveu um código mais preciso em duas das nossas três tarefas de programação.
Quanto custa o Muse Wonder?
Na Meta Model API, o Muse Wonder custa US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. No Overchat AI, uma mensagem para o Muse Wonder custa 5 créditos, e o plano Pro com 8.000 créditos por mês custa US$ 14,99.
Qual é a diferença entre o Muse Wonder e o Muse Wonder Full?
O Muse Wonder Full é a versão mais forte do modelo, com 56 pontos no Artificial Analysis Intelligence Index, contra 52 do Muse Wonder. O Muse Wonder Full está disponível apenas no Muse Code, nos planos de US$ 50 e US$ 200, e o Muse Wonder está disponível pela Meta Model API e nos apps que o usam.
O Muse Wonder é open source?
O Muse Wonder não é open source: a Meta não liberou os pesos do Muse Wonder nem do Muse Spark, e os dois modelos estão disponíveis apenas pela API e pelos apps da Meta. O único modelo de pesos abertos da família Muse é o Muse Glimmer, um modelo de 30 bilhões de parâmetros.
Onde posso usar o Muse Wonder?
O Muse Wonder está disponível no Overchat AI, pela Meta Model API e no Muse Code. A Meta também planeja adicioná-lo ao Muse, seu app de agente pessoal de IA.