Os geradores de imagens com IA transformam uma descrição curta em texto em uma foto, uma ilustração ou uma renderização 3D em poucos segundos. Neste artigo, você vai entender como esses modelos são treinados, o que acontece dentro de um modelo de difusão depois que você digita um prompt, quais tipos de modelos de geração de imagens existem e como a IA edita imagens já existentes.
Como funcionam os modelos de geração de imagens com IA?
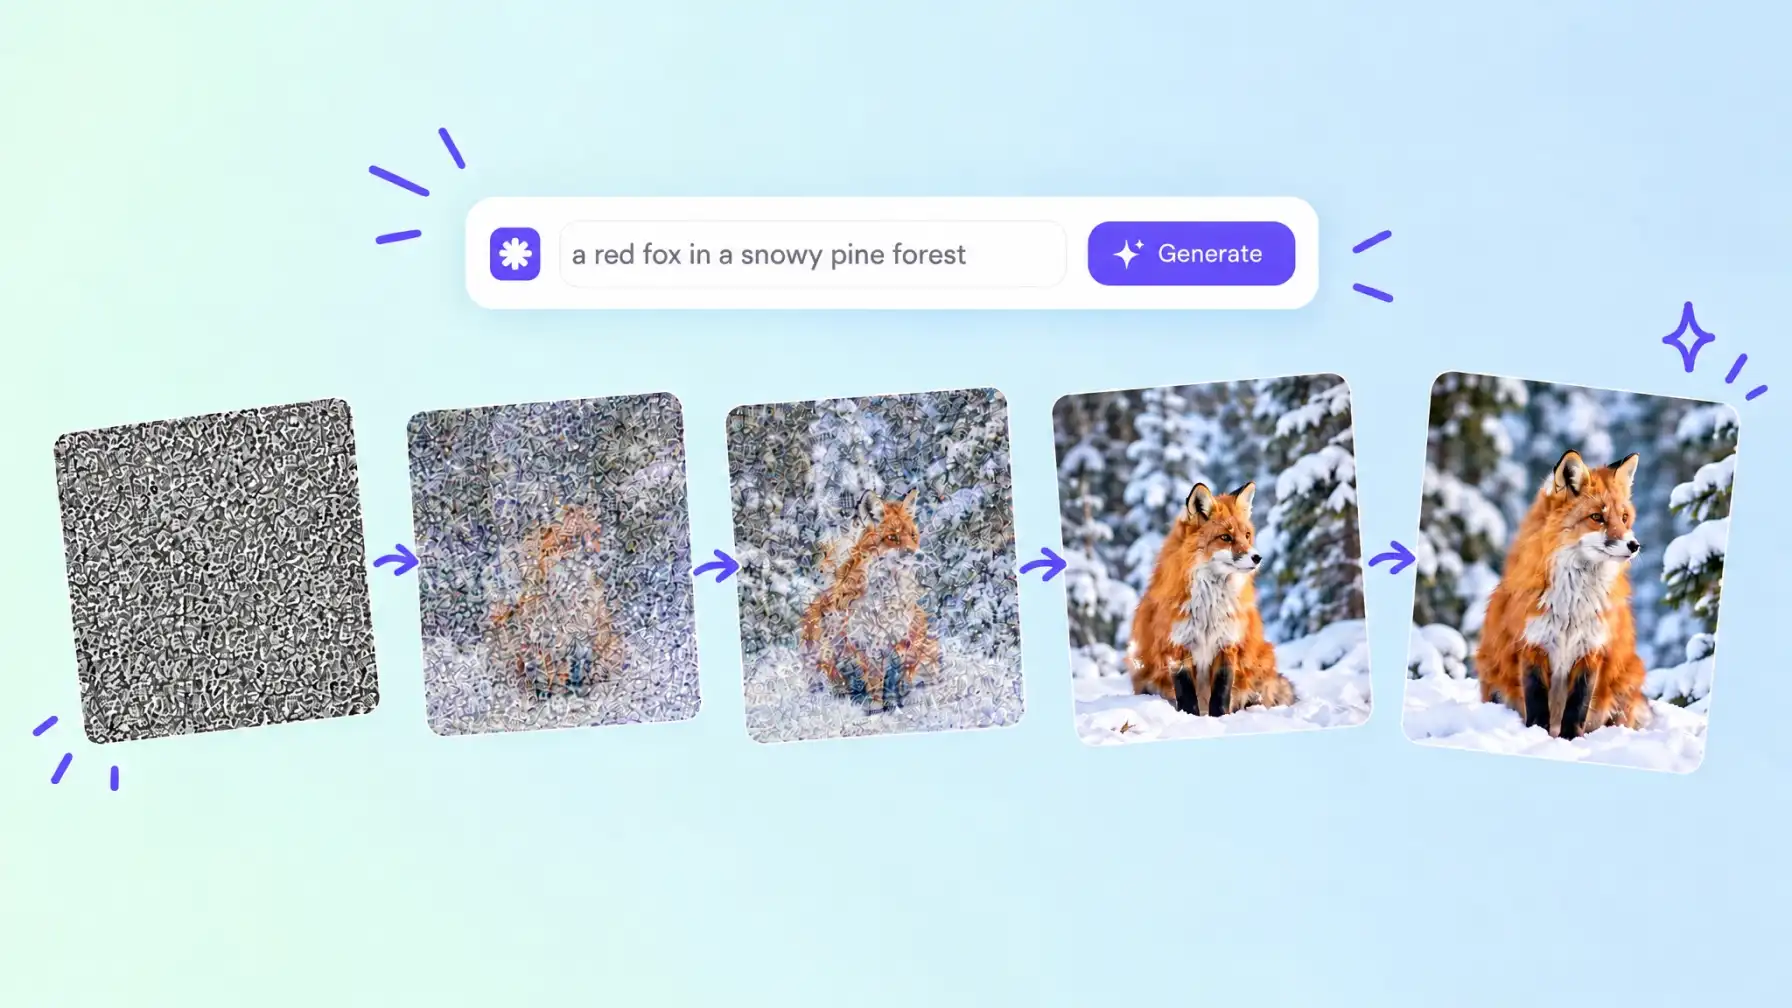
A IA gera imagens com modelos generativos treinados em grandes conjuntos de dados de imagens acompanhadas de descrições em texto. Durante o treinamento, o modelo aprende quais características visuais correspondem a quais palavras. Para criar uma imagem, ele converte o prompt em números e monta uma imagem que corresponde a ele. A maioria dos geradores atuais, incluindo Stable Diffusion, Imagen e FLUX, são modelos de difusão: eles partem de um ruído aleatório e o removem passo a passo até que surja uma imagem. Outros modelos, como o gerador de imagens do ChatGPT, são autorregressivos e constroem a imagem parte por parte.
Como os modelos de imagem com IA são treinados
Um modelo de geração de imagens é treinado com um conjunto de dados de imagens associadas a textos, como legendas ou o texto alternativo (alt text) de imagens em páginas da web. O Stable Diffusion foi treinado com a parte em inglês do LAION-5B, um conjunto de dados público com 5,85 bilhões de pares de imagem e texto extraídos do Common Crawl, um arquivo de páginas da web. A Adobe treinou seus modelos Firefly com conteúdo licenciado, como o Adobe Stock, e com conteúdo de domínio público.
Durante o treinamento, o modelo processa esses pares muitas vezes e ajusta seus parâmetros internos para associar palavras a características visuais, como formas, cores, texturas e estilos. Depois do treinamento, essas associações ficam armazenadas nos parâmetros do modelo, que são valores numéricos. As imagens de treinamento em si não ficam armazenadas no modelo.
Como a IA transforma um prompt de texto em imagem
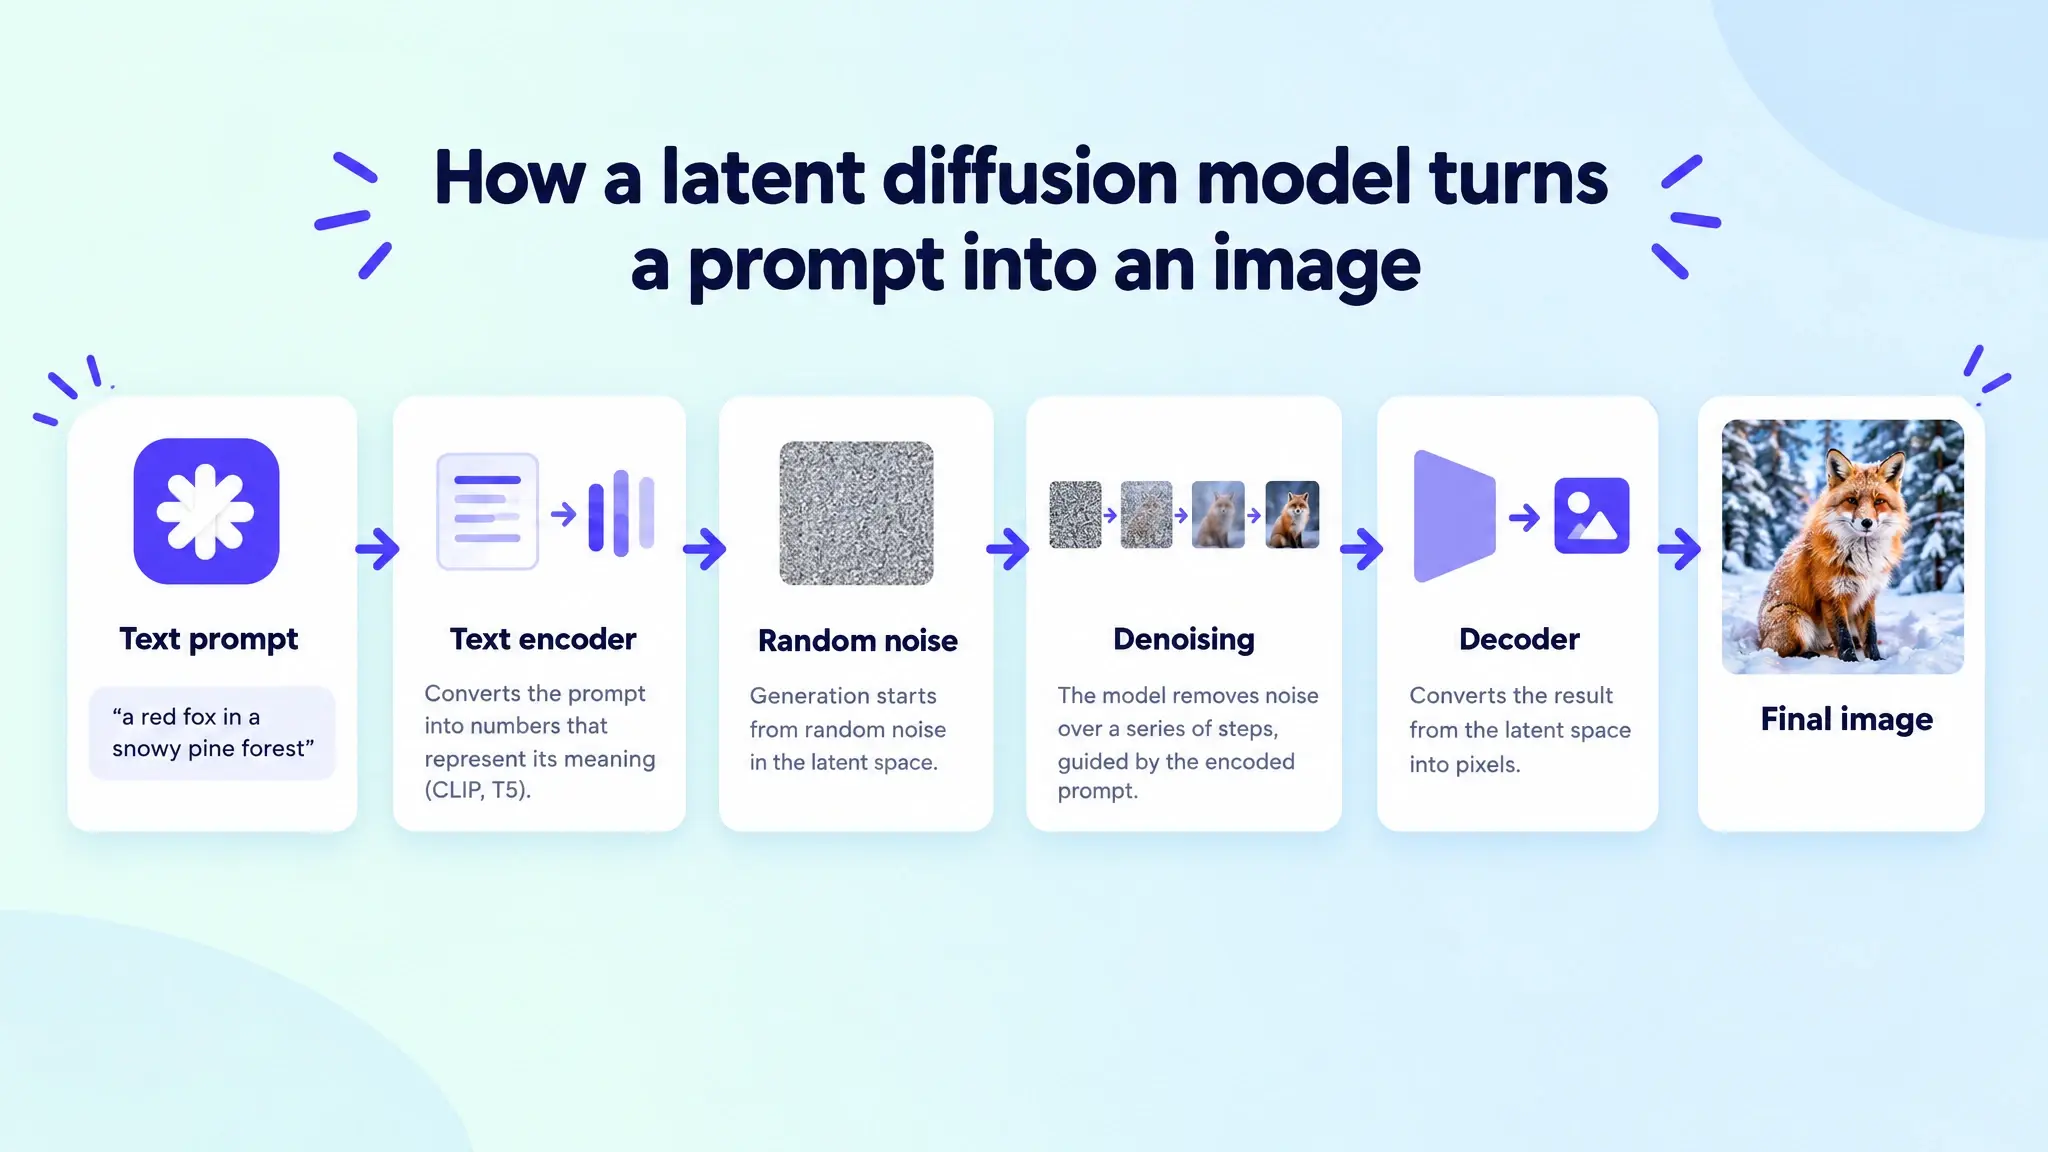
Em um modelo de difusão, a geração de uma imagem a partir de um prompt de texto tem quatro etapas.
Etapa 1: Converter o prompt em números
Um codificador de texto converte o prompt em um conjunto de números que representa o seu significado. O Stable Diffusion usa o CLIP, um modelo que a OpenAI treinou com 400 milhões de pares de imagem e texto. O Imagen, do Google, usa o T5, um modelo de linguagem treinado apenas com texto.
Etapa 2: Criar o ruído aleatório
A geração começa com uma imagem formada por ruído aleatório. Durante o treinamento, o modelo recebeu imagens reais com quantidades crescentes de ruído e aprendeu a prever esse ruído. Como o ruído inicial é aleatório, o mesmo prompt gera uma imagem diferente a cada vez.
Etapa 3: Remover o ruído passo a passo
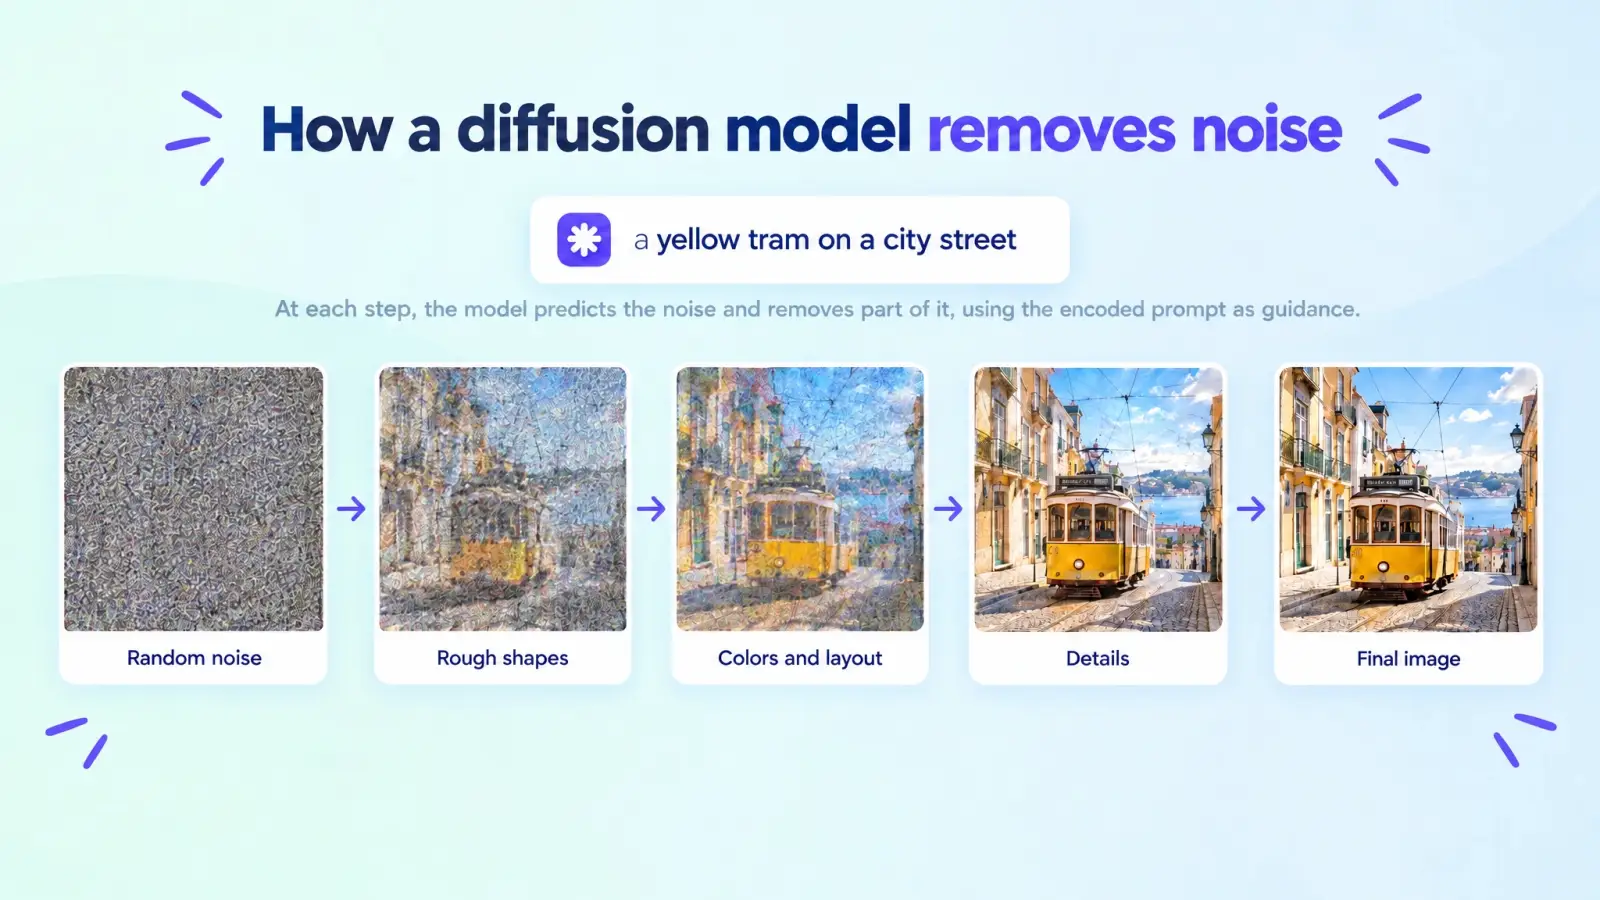
O modelo remove o ruído ao longo de uma série de etapas. Em cada etapa, ele prevê qual parte da imagem atual é ruído e subtrai uma parte dele, usando o prompt codificado como guia. As primeiras etapas definem a composição geral e as cores, e as últimas acrescentam os detalhes. O número de etapas depende do modelo. O FLUX.1 [schnell], da Black Forest Labs, gera uma imagem em 1 a 4 etapas.
Etapa 4: Transformar o resultado em uma imagem completa
Muitos modelos de difusão, chamados de modelos de difusão latente, removem o ruído de uma representação comprimida da imagem, chamada de espaço latente, o que exige menos processamento. Depois da última etapa, um decodificador converte o resultado do espaço latente em uma imagem em resolução completa.
Tipos de modelos de geração de imagens com IA
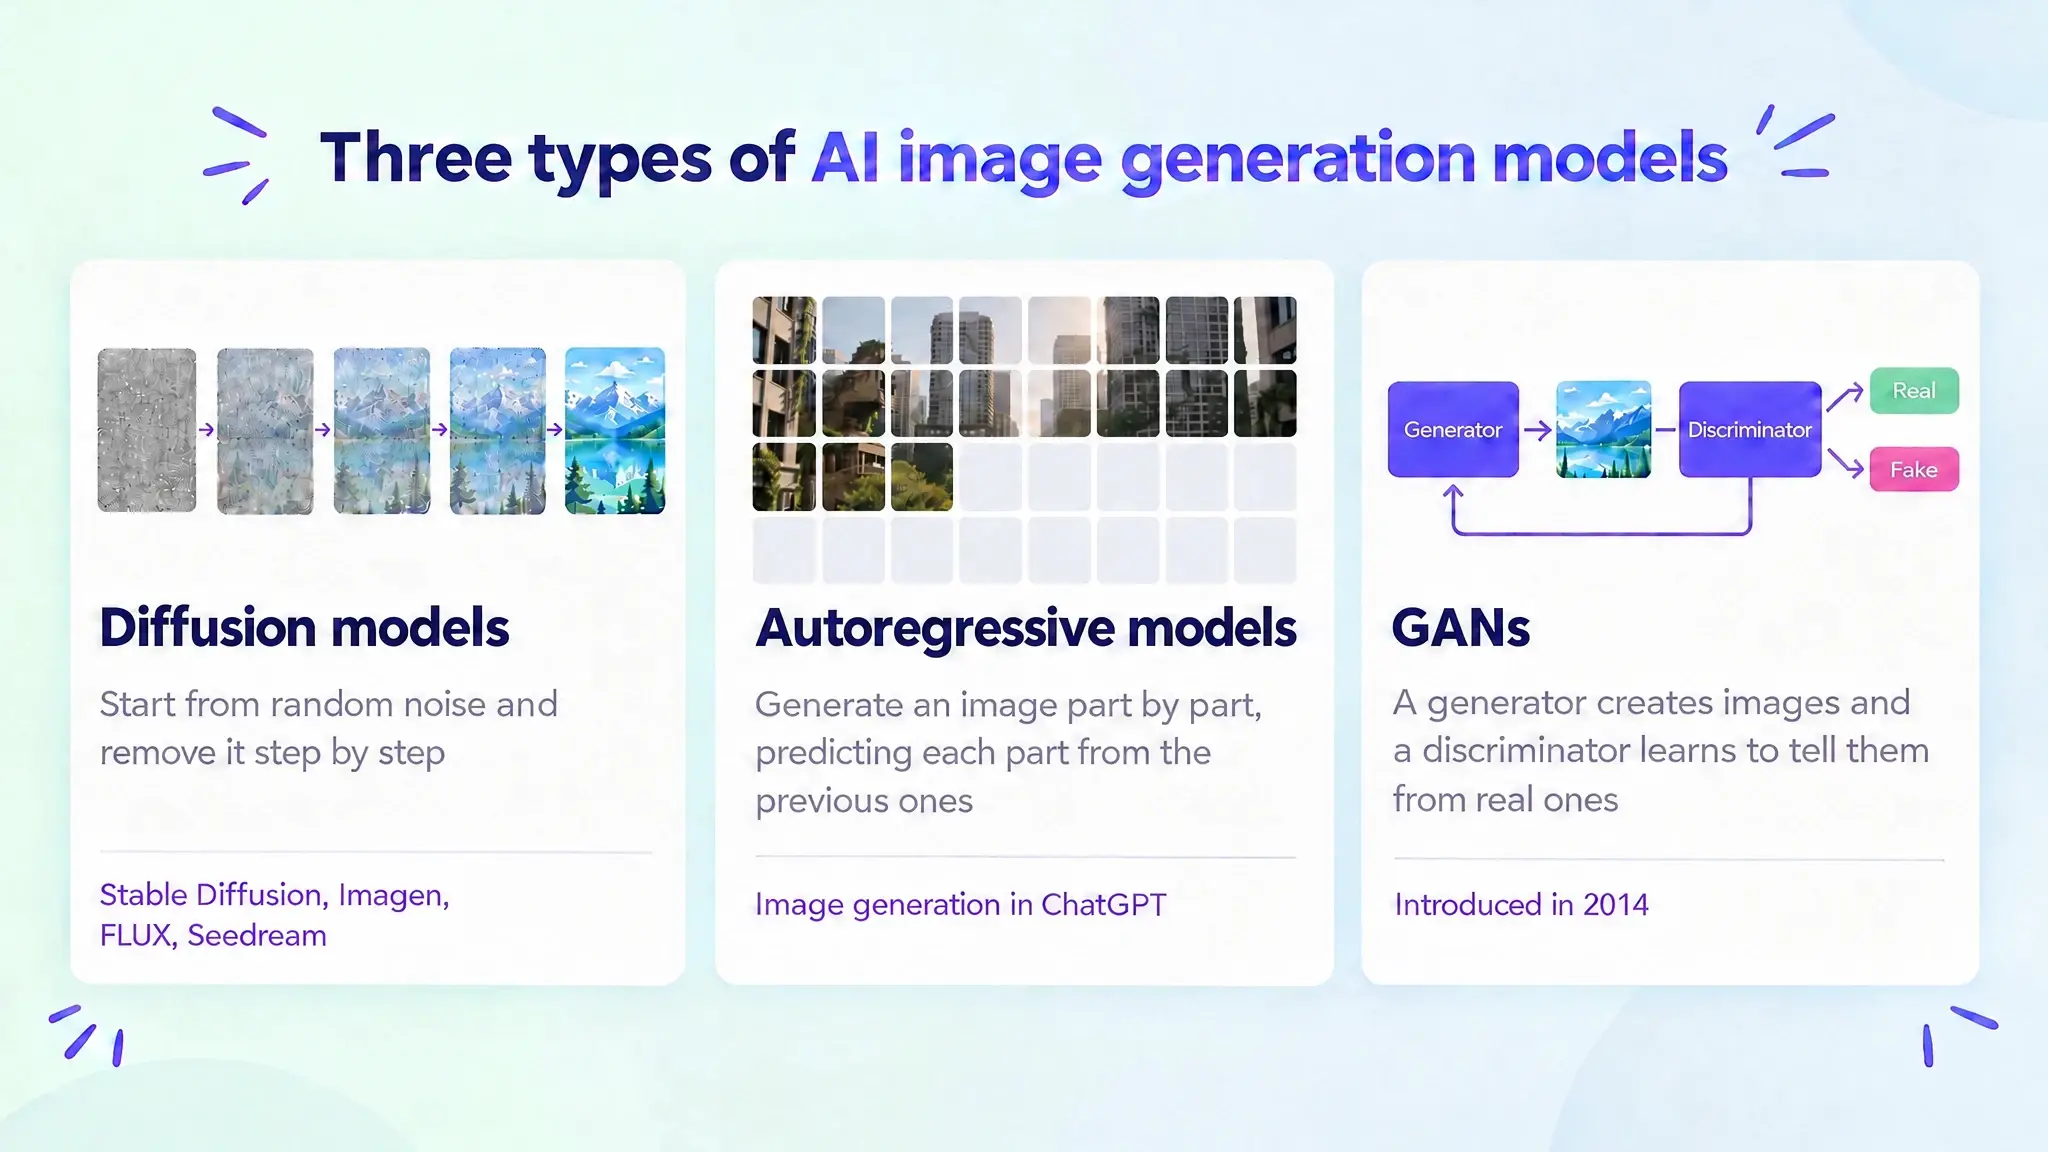
Existem três tipos principais de modelos de geração de imagens: modelos de difusão, modelos autorregressivos e redes adversariais generativas (GANs).
Modelos de difusão
Os modelos de difusão geram uma imagem removendo o ruído aos poucos, como descrito acima. O Stable Diffusion e o Imagen, do Google, são modelos de difusão. O FLUX, da Black Forest Labs, e o Seedream, da ByteDance, são modelos de difusão construídos sobre transformers, a arquitetura de rede neural também usada nos grandes modelos de linguagem.
Modelos autorregressivos
Os modelos autorregressivos geram uma imagem como uma sequência de partes e preveem cada parte a partir das partes geradas antes dela, da mesma forma que um modelo de linguagem prevê a próxima palavra. O gerador de imagens do ChatGPT, que a OpenAI lançou como GPT-4o image generation em março de 2025, é um modelo autorregressivo integrado ao ChatGPT. Como o mesmo modelo processa texto e imagens, ele também consegue receber imagens enviadas pelo usuário e modificá-las.
GANs
Uma rede adversarial generativa (GAN) é formada por duas redes neurais: um gerador, que cria imagens, e um discriminador, que tenta distingui-las de imagens reais. As duas redes são treinadas juntas, e o gerador melhora à medida que o discriminador fica melhor em identificar as imagens dele. As GANs foram apresentadas em 2014 e eram o principal método de geração de imagens antes dos modelos de difusão. Os geradores atuais de imagens a partir de texto usam principalmente modelos de difusão ou autorregressivos.
Como a IA edita uma imagem existente
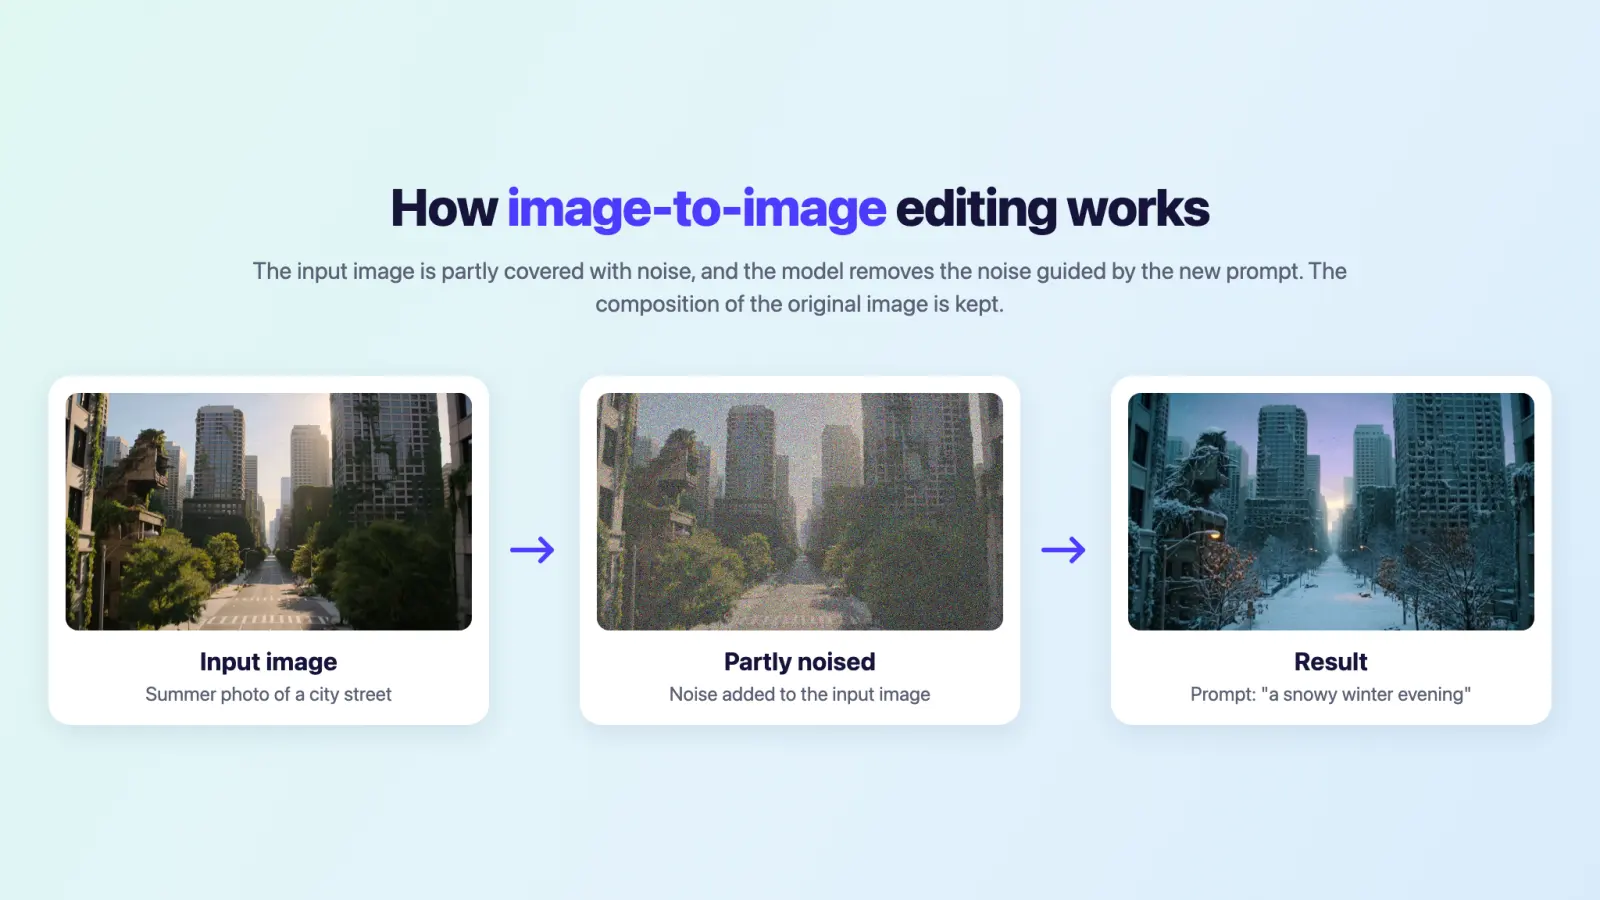
Editar uma imagem existente com IA se chama geração imagem para imagem. Em um modelo de difusão, a imagem de entrada é coberta parcialmente por ruído, e o modelo então remove esse ruído, guiado pelo novo prompt. Como o ruído não substitui totalmente a imagem original, o resultado mantém a composição dela. A quantidade de ruído adicionado determina o quanto o resultado se afasta do original.
Em um teste no Overchat AI, o Nano Banana 2 recebeu uma foto de uma rua da cidade no verão e um prompt para transformar a cena em uma noite de inverno com neve. O resultado manteve a rua, os prédios e a disposição deles, e mudou a estação do ano e a iluminação.
Esses modelos estão disponíveis nos produtos dos próprios desenvolvedores, como o ChatGPT, e em plataformas que oferecem modelos de vários desenvolvedores. O Overchat AI oferece 15 modelos de imagem, incluindo Nano Banana 2, GPT Image 2.5, Seedream 5 e Flux 2 Max.
Perguntas frequentes
De onde a IA tira as imagens?
Os modelos de geração de imagens são treinados com grandes conjuntos de dados de imagens com descrições em texto. A maioria desses conjuntos é coletada da web pública. O LAION-5B, por exemplo, foi montado a partir do Common Crawl, associando imagens ao texto alternativo delas. Alguns desenvolvedores usam dados licenciados: a Adobe treina o Firefly com o Adobe Stock e conteúdo de domínio público. Ao gerar uma imagem, o modelo usa o que aprendeu durante o treinamento e não busca imagens no conjunto de dados.
A IA copia imagens existentes?
Na maioria dos casos, não. O modelo gera cada imagem a partir dos padrões que aprendeu, então o resultado é uma imagem nova. Porém, os modelos podem memorizar algumas das imagens de treinamento. Em um estudo de 2023, pesquisadores extraíram mais de mil imagens de treinamento do Stable Diffusion e do Imagen, incluindo fotos de pessoas reais e logotipos de marcas registradas.
As imagens geradas por IA são minhas?
Isso depende da legislação local e do grau de contribuição humana. Nos Estados Unidos, o Copyright Office concluiu que apenas escrever prompts não torna o usuário autor de uma imagem, e o material gerado inteiramente por IA não é protegido por direitos autorais. As edições humanas no resultado e a seleção e organização criativas de material gerado por IA podem ser protegidas. Os termos de uso de cada produto de IA definem como o resultado pode ser usado.
Quanto tempo a IA leva para gerar uma imagem?
A geração costuma levar de alguns segundos a cerca de meio minuto, dependendo do modelo, da resolução e das configurações de qualidade. No Overchat AI, o Nano Banana 2 gerou uma imagem em 1K em cerca de 20 segundos, e o GPT Image 2.5 Sunburst gerou uma imagem em qualidade média em 25 segundos. O Seedream 4.0 consegue gerar uma imagem em 2K em menos de dois segundos.
Dá para gerar imagens com IA de graça?
Sim. O ChatGPT e o Gemini incluem geração de imagens nos planos gratuitos, com limites diários, e outros geradores de imagens com IA gratuitos também oferecem uso gratuito limitado.