


Sobre o Claude Opus 5.5
O Claude Opus 5.5 é o modelo principal da Anthropic para projetos longos de código, revisão de código e trabalho intelectual, lançado em 22 de setembro de 2026. Ele lê até 1 milhão de tokens de texto, código, imagens e arquivos em uma conversa, escreve até 128 mil tokens em uma resposta e pensa mais nos problemas difíceis do que nos simples
O Claude Opus 5.5 marca 66,4% no Terminal-Bench 4.0, à frente do GPT-6 Astra, com 57,9%, e do Claude Fable 5.1, com 55,8%, e 1846 de Elo no GDPval-AA, um teste de trabalho real de 44 profissões. Ele audita e migra bases de código inteiras, encontra bugs entre arquivos e escreve respostas curtas e claras, com o ponto principal primeiro
Na Overchat AI, o Claude Opus 5.5 fica no mesmo chat que o GPT-6, o Gemini, o Grok e o DeepSeek, então você pode conferir uma resposta com outro modelo sem abrir uma nova conversa
- Modalidades
- Intelligence Index?
- 59
- Janela de contexto?
- 1M de tokens
- Lançamento
- 22/09/2026
Claude Opus 5.5 e outros modelos
O Claude Opus 5.5 está em 3º lugar no Artificial Analysis Intelligence Index entre 54 modelos
- 65
 Claude Fable 5.2
- 60
 Gemini 4 Carbon
- 59Claude Opus 5.5
- 57
 GPT-6 Astra
- 55GPT-6.1 Sol
- 50
 Muse Wonder Full
- 46
 Kimi K3.1 Pro
- 44Muse Wonder
- 35
 Grok 4.7
- 33
 DeepSeek V4.1 Flash
- #2de 136 modelosSciCodeCódigo Python para computação científica
- #3de 63 modelosAA-OmnisciencePerguntas de conhecimento respondidas corretamente
- #3de 288 modelosCritPtProblemas de física de nível de pesquisa
- #6de 292 modelosAA-LCRPerguntas que exigem raciocínio sobre documentos muito longos
Fonte: Artificial Analysis
Compare o Claude Opus 5.5
Claude Opus 5.5 vs Claude Fable 5.1
O Claude Opus 5.5 pontua mais que o Claude Fable 5.1 em 8 de 8 benchmarks. A maior vantagem é no Terminal-Bench 4.0: 66.4% contra 55.8%
- Benchmarks vencidos
- Claude Opus 5.5: 8
- Claude Fable 5.1: 0
- Pontuação média
- Claude Opus 5.5: 64.5%
- Claude Fable 5.1: 59.6%
- Terminal-Bench 4.0+10.6
- AutomationBench+8.6
- Terminal-Bench-Science 0.1+6.1
- CursorBench 4.0+6.0
- FrontierCode v1.1+4.1
- Humanity's Last Exam+2.1
- OSWorld 2.1+1.1
- Chartography+0.6
Claude Opus 5.5 vs GPT-6 Astra
O Claude Opus 5.5 pontua mais que o GPT-6 Astra em 3 de 5 benchmarks. A maior vantagem é no Humanity's Last Exam: 67.7% contra 57.2%. O GPT-6 Astra está à frente no Terminal-Bench-Science 0.1: 64.6% contra 58.7%. O Claude Opus 5.5 escreve 88 tokens por segundo, o GPT-6 Astra escreve 48
- Benchmarks vencidos
- Claude Opus 5.5: 3
- GPT-6 Astra: 2
- Pontuação média
- Claude Opus 5.5: 57.4%
- GPT-6 Astra: 54.9%
- Velocidade de saída, tokens/s
- Claude Opus 5.5: 88
- GPT-6 Astra: 48
- Tempo até o primeiro token, s (escala logarítmica)
- Claude Opus 5.5: 1.9
- GPT-6 Astra: 3.2
- Humanity's Last Exam+10.5
- Terminal-Bench 4.0+8.5
- FrontierCode v1.1+1.1
- AutomationBench−1.4
- Terminal-Bench-Science 0.1−5.9
- CursorBench 4.0—
- OSWorld 2.1—
- Chartography—
Melhor modelo por caso de uso
Pontuação média do Claude Opus 5.5 e de 2 outros modelos por caso de uso
Código
?Média de 3 testes- 1Claude Opus 5.559.8%
- 2GPT-6 Astra58.6%
- 3Claude Fable 5.152.9%
Agentes
?AutomationBench- 1GPT-6 Astra41.4%
- 2Claude Opus 5.540.0%
- 3Claude Fable 5.131.4%
Trabalho intelectual
?Humanity's Last Exam- 1Claude Opus 5.567.7%
- 2Claude Fable 5.165.6%
- 3GPT-6 Astra57.2%
Benchmarks do Claude Opus 5.5
Compare o Claude Opus 5.5 com Claude Fable 5.1 e GPT-6 Astra em 9 benchmarks que medem código, agentes e trabalho intelectual
Código
- Terminal-Bench 4.0?Claude Opus 5.566.4%Claude Fable 5.155.8%GPT-6 Astra57.9%66.4%+8.5
- FrontierCode v1.1?Claude Opus 5.554.4%Claude Fable 5.150.3%GPT-6 Astra53.3%54.4%+1.1
- CursorBench 4.0?Claude Opus 5.557.8%Claude Fable 5.151.8%GPT-6 Astra—57.8%+6.0
- Terminal-Bench-Science 0.1?Claude Opus 5.558.7%Claude Fable 5.152.6%GPT-6 Astra64.6%58.7%−5.9
Agentes
- OSWorld 2.1?Claude Opus 5.581.8%Claude Fable 5.180.7%GPT-6 Astra—81.8%+1.1
- AutomationBench?Claude Opus 5.540.0%Claude Fable 5.131.4%GPT-6 Astra41.4%40.0%−1.4
Trabalho intelectual
- GDPval-AA v2.1?Claude Opus 5.51846.0%Claude Fable 5.11735.0%GPT-6 Astra1542.0%1846.0%+111.0
- Humanity's Last Exam?Claude Opus 5.567.7%Claude Fable 5.165.6%GPT-6 Astra57.2%67.7%+2.1
- Chartography?Claude Opus 5.589.0%Claude Fable 5.188.4%GPT-6 Astra—89.0%+0.6
Fontes: Anthropic, apresentação do Claude Opus 5.5 (22/09/2026), Artificial Analysis, Claude Opus 5.5
Velocidade do Claude Opus 5.5
A velocidade de saída é a rapidez com que o modelo escreve (tokens por segundo, quanto maior, melhor). O tempo até o primeiro token é quanto você espera até a resposta começar (quanto menor, melhor)
Velocidade de saída e tempo até o primeiro token de 35 modelos
?Percentil| Modelos | Velocidade de saída, tokens/s (escala logarítmica) | Tempo até o primeiro token, s (escala logarítmica) |
|---|---|---|
| GPT-6 Luna | 143 | 2.4 |
| GPT-6.1 Terra | 75 | 4.3 |
| GPT-6.1 Sol | 58 | 2.9 |
| GPT-6 Astra | 48 | 3.2 |
| Claude Opus 5.5 | 88 | 1.9 |
| Claude Opus 5 | 54 | 2.6 |
| Claude Opus 4.8 | 59 | 1.3 |
| Claude Fable 5.2 | 84 | 2.3 |
| Claude Sonnet 5.5 | 102 | 1 |
| Claude 5 Sonnet | 215 | 10.5 |
| Claude Sonnet 4.6 | 220 | 10.8 |
| Claude Haiku 5.5 | 167 | 2.1 |
| Gemini 4 Carbon | 169 | 29.5 |
| Gemini 4 Argon | 91 | 6 |
| Gemini 3.8 Flash | 203 | 7.5 |
| Gemini 3 Pro | 270 | 11.2 |
| Grok 4.7 | 81 | 8.9 |
| Grok 4.6 | 290 | 32 |
| Qwen 3.8 Max | 81 | 30.6 |
| DeepSeek V4 Pro | 144 | 1.1 |
| DeepSeek V4.1 Flash | 422 | 2.2 |
| Mistral Large 4 | 226 | 8.6 |
| Hy4 | 214 | 37.7 |
| ERNIE 5.5 Flash | 405 | 2.7 |
| Muse Wonder | 980 | 8.7 |
| Muse Spark | 1129 | 6.2 |
| Kimi K3.1 Pro | 340 | 7.4 |
| Kimi K3 | 338 | 5.9 |
| GLM 5.3 | 197 | 1.2 |
| Flint | 194 | 12.3 |
| Llama 4 | 81 | 0.7 |
| Claude 4.5 Haiku | 162 | 0.9 |
| MiniMax M3 | 169 | 4.5 |
| MiniMax M3.1 Flash | 656 | 7.2 |
| Kimi K2.7 Code | 455 | 3.6 |
Teste de digitação
Todos os modelos escrevem a mesma resposta. O teste espera o tempo do modelo até o primeiro token, depois imprime o texto na velocidade de saída do modelo e mostra o tempo total
- Claude Opus 5.588 tokens/s1.9 s até o primeiro token
- GPT-6 Astra48 tokens/s3.2 s até o primeiro token
Fonte: Overchat AI, 2026-11-11
Veja como o Claude Opus 5.5 responde
Exemplos de respostas do Claude Opus 5.5 a 3 prompts: Encontrar um bug, Resumir uma conversa e Conferir os números. Cada resposta é a saída do modelo, sem edições
Esta função deveria retornar o uso total de um mês de cobrança, mas os clientes dizem que o último dia do mês nunca é cobrado. Encontre o bug, explique em duas frases e me dê o código corrigido. ```python from datetime import datetime, timedelta def month_bounds(year, month): start = datetime(year, month, 1) nxt = datetime(year + month // 12, month % 12 + 1, 1) return start, nxt - timedelta(days=1) def monthly_usage(events, year, month): start, end = month_bounds(year, month) return sum(e.amount for e in events if start <= e.ts <= end) ```
Claude Opus 5.5Bug: month_bounds retorna como fim do mês nxt - timedelta(days=1), que é o último dia às 00:00:00, e não o fim desse dia. Como o filtro usa e.ts <= end, qualquer evento do último dia ocorrido depois da meia-noite (ou seja, quase todos) fica de fora.
Correção: use um intervalo semiaberto [início do mês, início do mês seguinte), que não depende de horário nem de precisão de microssegundos:
from datetime import datetime

def month_bounds(year, month):
    start = datetime(year, month, 1)
    nxt = datetime(year + month // 12, month % 12 + 1, 1)
    return start, nxt  # fim exclusivo: início do mês seguinte

def monthly_usage(events, year, month):
    start, end = month_bounds(year, month)
    return sum(e.amount for e in events if start <= e.ts < end)
O cálculo de nxt já estava correto, inclusive na virada de dezembro para janeiro. O único problema era o limite final inclusivo à meia-noite.
Resuma esta conversa do Slack para o meu gestor em três tópicos curtos: o problema, o que já foi resolvido e o que falta. Lena: A página de checkout quebrou para usuários do Safari depois do lançamento de terça. Cerca de 12% dos pedidos falharam por dois dias. Omar: A causa é uma atualização da biblioteca de seletor de datas. Reverti hoje de manhã e o checkout no Safari voltou a funcionar. Lena: O suporte tem 340 chamados sobre pagamentos com falha. Dá para estornar as cobranças extras? Mei: O financeiro confirmou que 58 clientes foram cobrados duas vezes. Os estornos saem hoje. Omar: Vou incluir o Safari nos testes de lançamento para isso não acontecer de novo. Fica pronto até sexta. Lena: Vou mandar um cupom de 10% por e-mail para os clientes afetados assim que os estornos caírem.
Claude Opus 5.5- Problema: Após o lançamento de terça, uma atualização da biblioteca de seletor de datas quebrou o checkout no Safari. Cerca de 12% dos pedidos falharam durante dois dias, gerando 340 chamados no suporte, e 58 clientes foram cobrados em duplicidade.
- Resolvido: Omar reverteu a atualização hoje de manhã e o checkout no Safari voltou a funcionar.
- Pendente: Os estornos dos 58 clientes saem hoje (Mei/financeiro). Depois disso, Lena enviará um cupom de 10% aos clientes afetados. Até sexta, Omar incluirá o Safari nos testes de lançamento para evitar que o problema se repita.
Nossa startup tem R$ 5,5 milhões em caixa, receita mensal de R$ 200 mil crescendo 8% ao mês e custos mensais fixos de R$ 600 mil. Em que mês atingimos o ponto de equilíbrio e o dinheiro acaba antes disso? Mostre a conta em uma tabela curta.
Claude Opus 5.5Ponto de equilíbrio: mês 16, sem o caixa acabar
Premissas: receita de R$ 200 mil no mês 1, crescendo 8% ao mês. Custos fixos de R$ 600 mil por mês. Valores em R$ mil.
| Mês | Receita | Custos | Resultado do mês | Caixa no fim do mês |
|---|---|---|---|---|
| 1 | 200,0 | 600 | −400,0 | 5.100,0 |
| 2 | 216,0 | 600 | −384,0 | 4.716,0 |
| 3 | 233,3 | 600 | −366,7 | 4.349,3 |
| 6 | 293,9 | 600 | −306,1 | 3.367,2 |
| 9 | 370,2 | 600 | −229,8 | 2.597,5 |
| 12 | 466,3 | 600 | −133,7 | 2.095,4 |
| 13 | 503,6 | 600 | −96,4 | 1.999,1 |
| 14 | 543,9 | 600 | −56,1 | 1.943,0 |
| 15 | 587,4 | 600 | −12,6 | 1.930,4 (mínimo) |
| 16 | 634,4 | 600 | +34,4 | 1.964,9 |
Como chegar ao mês
- A receita precisa triplicar, de 200 para 600. Isso exige 1,08ⁿ ≥ 3, ou seja, n ≥ ln 3 / ln 1,08 ≈ 14,3 períodos de crescimento.
- Arredondando para cima, são 15 períodos de crescimento. Como o mês 1 já tem receita de 200, o equilíbrio cai no mês 16.
Queima total até o equilíbrio
- Custos dos meses 1 a 15: 15 × 600 = R$ 9.000 mil
- Receitas dos meses 1 a 15: 200 × (1,08¹⁵ − 1) / 0,08 ≈ R$ 5.430 mil
- Queima acumulada: ≈ R$ 3,57 milhões
Conclusão
- O ponto de equilíbrio ocorre no mês 16.
- O dinheiro não acaba antes. O caixa chega ao mínimo de cerca de R$ 1,93 milhão no mês 15 e volta a subir a partir do mês 16.
Sensibilidade:
- Se o crescimento cair para cerca de 5% ao mês, o equilíbrio passa para o mês 24 e o caixa fica perto de zero.
- Se os custos também crescerem, o cenário piora rapidamente. Vale monitorar esses dois fatores.
Mais prompts para testar com o Claude Opus 5.5
Em que o Claude Opus 5.5 se destaca
Projetos longos de código
O Claude Opus 5.5 assume migrações, auditorias e refatorações que atravessam uma base de código inteira e continua até os testes passarem. Ele marca 66,4% no Terminal-Bench 4.0 e 57,8% no CursorBench 4.0, à frente do Claude Fable 5.1 e do Opus 5
Revisão de código e correção de bugs
Cole um diff ou anexe um arquivo, e o Opus 5.5 aponta a linha que quebra, explica o motivo em palavras simples e escreve a correção. Ele vai além da primeira causa plausível e confere como as partes do código se encaixam
Relatórios, modelos e análises
Dê ao Opus 5.5 anotações, números e documentos, e ele devolve um relatório, um modelo financeiro ou o roteiro de uma apresentação. Ele marca 1846 de Elo no GDPval-AA, à frente do Claude Fable 5.1, com 1735, e do GPT-6 Astra, com 1542
Resumos claros
O Opus 5.5 escreve respostas curtas, com o ponto mais importante primeiro e sem jargão, então uma conversa longa, uma reunião ou um relatório vira um resumo que o seu gestor lê em um minuto
Como usar o Claude Opus 5.5 na Overchat AI
Use o chat do topo desta página ou o app da Overchat AI na web, no iOS ou no Android
- 01
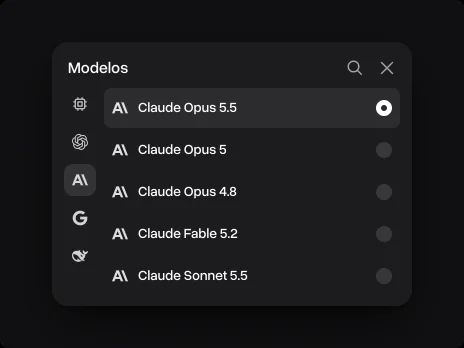
Escolha o Claude Opus 5.5
Ele já vem selecionado no chat desta página. No app da Overchat AI, abra a lista de modelos ao lado do campo de mensagem e selecione o Claude Opus 5.5
- 02
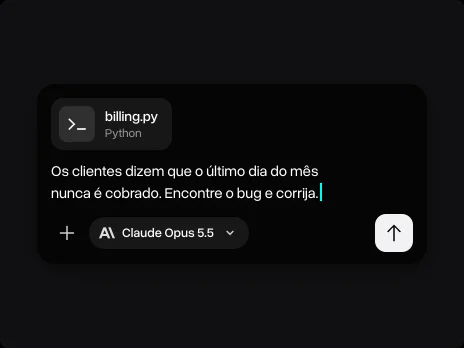
Anexe seu código ou um arquivo
Adicione código, um documento, uma planilha ou um print e escreva o que você precisa: o resultado, o formato e o que deve continuar igual
- 03
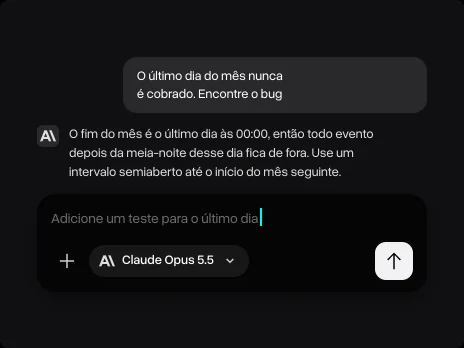
Continue no mesmo chat
Faça outra pergunta, peça testes ou uma versão mais curta, ou troque de modelo sem perder a conversa
Por que usar o Claude Opus 5.5 na Overchat AI
Uma conta para chat, imagens e vídeo, em todos os dispositivos
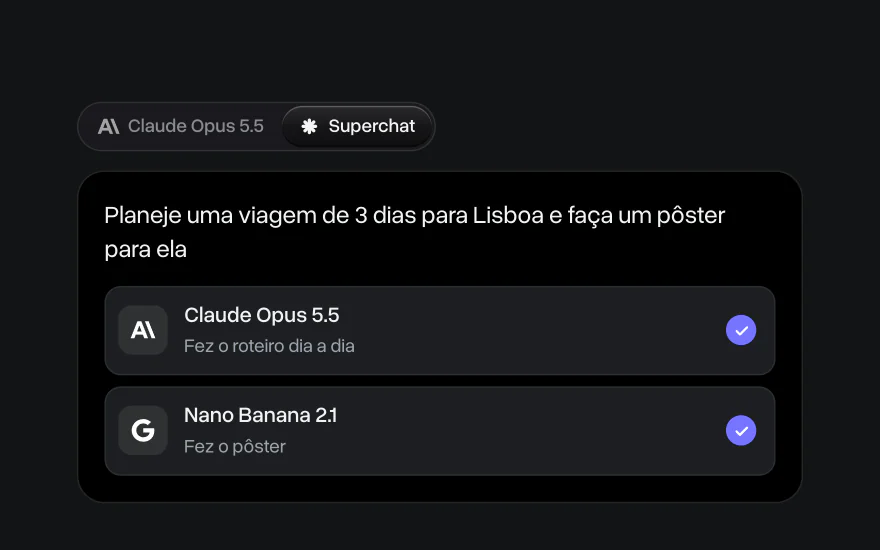
Agente de IA Superchat
O Superchat Agent envia sua mensagem automaticamente para o modelo mais adequado à tarefa. Ele gera imagens e vídeos, usa as ferramentas de IA da Overchat AI e aprende com suas interações para melhorar com o tempo
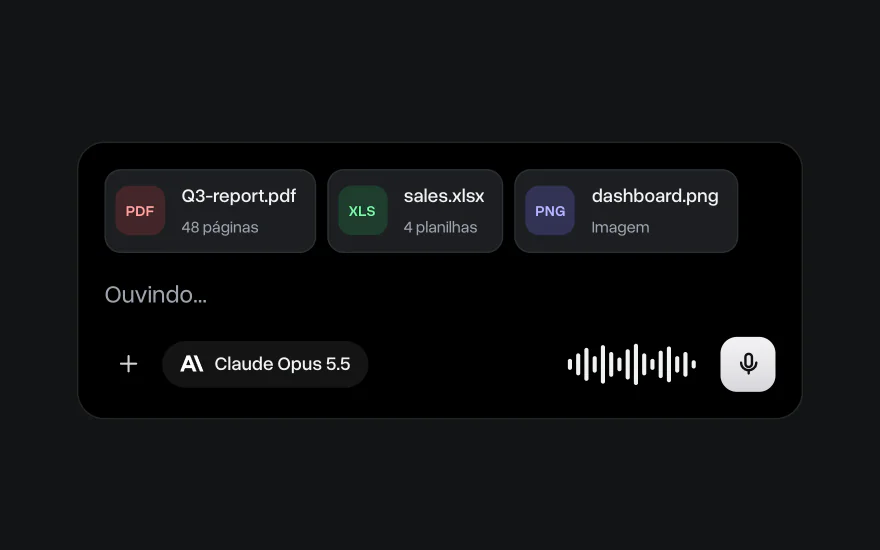
Converse com imagens e arquivos
Envie PDFs, planilhas, código e prints e pergunte ao Claude Opus 5.5 sobre eles. Você também pode ditar a mensagem em vez de digitar
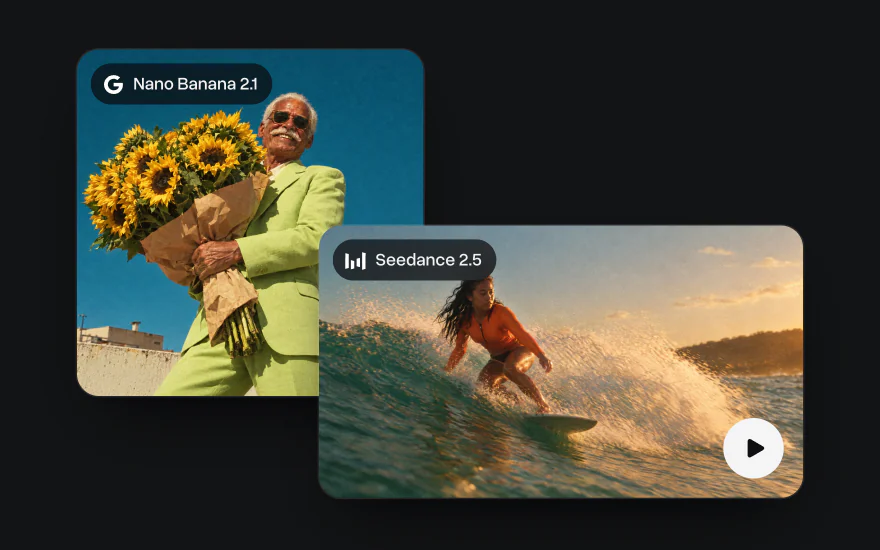
Vá além do texto
Gere imagens com Nano Banana e GPT Image e vídeos com Seedance e Kling na mesma conta, com os mesmos créditos do chat
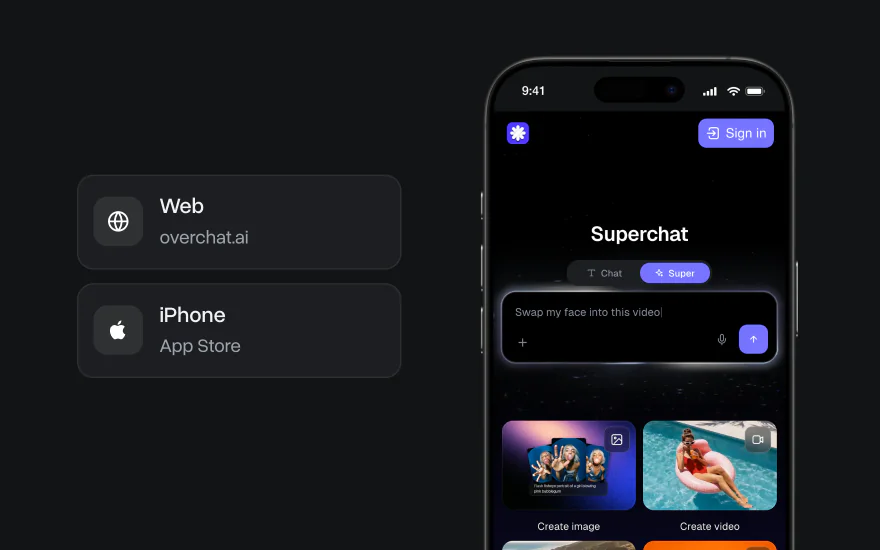
Na web e no iPhone
Comece um chat no notebook e termine no celular. O app da Overchat AI tem os mesmos modelos, e seus chats ficam em uma única conta em todos os dispositivos
Modelos Claude na Overchat AI
Compare 9 modelos Claude na Overchat AI por velocidade de saída, tempo até o primeiro token e preço de uma mensagem
Claude Opus 5.5Esta páginaClaude Sonnet 5.5Claude Sonnet 4.6Claude Haiku 5.5Claude 4.5 HaikuFonte: Overchat AI, 2026-11-11
Conheça outros modelos
Os modelos marcados como Em breve estão chegando à Overchat AI; os outros já estão disponíveis


Saiba mais sobre modelos de IA

Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder
Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder em três tarefas de programação. Veja benchmarks, velocidade e como usar
Muse Wonder vs Muse Spark: testamos o novo modelo da Meta
Comparamos o Muse Wonder e o Muse Spark 1.3 em lógica, escrita e programação. Veja benchmarks e qual modelo da Meta é melhor
10 melhores plataformas de IA tudo-em-um em 2026: por que uma assinatura de IA vale mais que várias
Compare as 10 melhores plataformas de IA tudo-em-um em 2026: preços, planos gratuitos e os modelos mais recentes, do Overchat AI ao Poe e ao Krater



