


Sobre o GLM 5.3
O GLM 5.3 é o modelo principal de pesos abertos da Z.ai para agentes de código, trabalho de segurança e tarefas longas. Ele tem 753 bilhões de parâmetros, dos quais 40 bilhões trabalham em cada token, lê até 1 milhão de tokens em uma conversa e sempre raciocina antes de responder
O GLM 5.3 marca 84,5% no CyberGym, o melhor resultado da sua comparação, e 28,3% no Terminal-Bench 3.0, à frente do Claude Opus 4.8, com 21,1%, e do Kimi K3, com 17,4%. Ele também lidera o AutomationBench, com 48,2%, e o GDPval-AA, com 1.769 pontos, um teste de trabalho real de dezenas de profissões
Na Overchat AI, o GLM 5.3 está no mesmo chat que o Claude Opus 5.5, o GPT-6 e o DeepSeek, então você pode comparar respostas e trocar de modelo sem começar de novo
- Modalidades
- Intelligence Index?
- 31,7
- Janela de contexto?
- 1M de tokens
- Lançamento
- 14/08/2026
GLM 5.3 vs outros modelos
O GLM 5.3 está em 21º lugar no Artificial Analysis Intelligence Index entre 54 modelos
- 59.1
 Claude Opus 5.5
- 54.6
 GPT-6.1 Sol
- 54.5Claude Sonnet 5.5
- 50.4
 Gemini 4 Argon
- 46.5
 Kimi K3.1 Pro
- 35.5
 Grok 4.7
- 34.6
 Hy4
- 33.7
 Qwen 3.8 Max
- 32.6
 DeepSeek V4.1 Flash
- 31.7
 GLM 5.3
- #3de 131 modelosτ-Bench BankingPedidos de clientes que um agente atende com as ferramentas e regras de um banco
- #13de 136 modelosSciCodeCódigo Python para computação científica
- #13de 166 modelosGDPval-AATarefas de trabalhos reais, avaliadas em comparação com o trabalho de especialistas
- #14de 130 modelosTerminal-Bench 4.0Tarefas de código em várias etapas que um agente conclui no terminal
Fonte: Artificial Analysis
Compare o GLM 5.3
GLM 5.3 vs Kimi K3
O GLM 5.3 pontua mais que o Kimi K3 em 8 de 13 benchmarks. A maior vantagem é no ExploitBench: 54.4% contra 32.2%. O Kimi K3 está à frente no SWE-Marathon v1.1: 48.1% contra 42.5%. O GLM 5.3 escreve 197 tokens por segundo, o Kimi K3 escreve 338
- Benchmarks vencidos
- GLM 5.3: 8
- Kimi K3: 5
- Pontuação média
- GLM 5.3: 53.4%
- Kimi K3: 50.1%
- Velocidade de saída, tokens/s
- GLM 5.3: 197
- Kimi K3: 338
- Tempo até o primeiro token, s (escala logarítmica)
- GLM 5.3: 1.2
- Kimi K3: 5.9
- ExploitBench+22.2
- Terminal-Bench 3.0+10.9
- PostTrainBench+7.8
- CyberGym+4.5
- HLE with tools+2.7
- ProgramBench+1.5
- AutomationBench+1.5
- Agents' Last Exam+0.9
- NL2Repo0.0
- Terminal-Bench 2.1−0.1
- DeepSWE v1.1−0.6
- Toolathlon Verified−3.5
- SWE-Marathon v1.1−5.6
- FrontierSWE—
GLM 5.3 vs DeepSeek V4 Pro
O GLM 5.3 pontua mais que o DeepSeek V4 Pro em 6 de 8 benchmarks. A maior vantagem é no AutomationBench: 48.2% contra 43.2%. O DeepSeek V4 Pro está à frente no NL2Repo: 61.1% contra 58.0%. O GLM 5.3 escreve 197 tokens por segundo, o DeepSeek V4 Pro escreve 144
- Benchmarks vencidos
- GLM 5.3: 6
- DeepSeek V4 Pro: 2
- Pontuação média
- GLM 5.3: 63.7%
- DeepSeek V4 Pro: 62.3%
- Velocidade de saída, tokens/s
- GLM 5.3: 197
- DeepSeek V4 Pro: 144
- Tempo até o primeiro token, s (escala logarítmica)
- GLM 5.3: 1.2
- DeepSeek V4 Pro: 1.1
- AutomationBench+5.0
- DeepSWE v1.1+4.2
- Agents' Last Exam+2.8
- HLE with tools+2.5
- CyberGym+1.2
- Terminal-Bench 2.1+0.3
- Toolathlon Verified−1.1
- NL2Repo−3.1
- Terminal-Bench 3.0—
- ProgramBench—
- FrontierSWE—
- SWE-Marathon v1.1—
- PostTrainBench—
- ExploitBench—
GLM 5.3 vs Qwen 3.8 Max
O GLM 5.3 pontua mais que o Qwen 3.8 Max em 10 de 10 benchmarks. A maior vantagem é no ExploitBench: 54.4% contra 28.8%. O GLM 5.3 escreve 197 tokens por segundo, o Qwen 3.8 Max escreve 81
- Benchmarks vencidos
- GLM 5.3: 10
- Qwen 3.8 Max: 0
- Pontuação média
- GLM 5.3: 58.3%
- Qwen 3.8 Max: 51.2%
- Velocidade de saída, tokens/s
- GLM 5.3: 197
- Qwen 3.8 Max: 81
- Tempo até o primeiro token, s (escala logarítmica)
- GLM 5.3: 1.2
- Qwen 3.8 Max: 30.6
- ExploitBench+25.6
- DeepSWE v1.1+10.3
- ProgramBench+8.5
- AutomationBench+8.4
- HLE with tools+6.3
- CyberGym+6.0
- NL2Repo+2.1
- Terminal-Bench 2.1+1.6
- Agents' Last Exam+1.5
- Toolathlon Verified+0.5
- Terminal-Bench 3.0—
- FrontierSWE—
- SWE-Marathon v1.1—
- PostTrainBench—
GLM 5.3 vs Claude Opus 4.8
O GLM 5.3 pontua mais que o Claude Opus 4.8 em 11 de 14 benchmarks. A maior vantagem é no ExploitBench: 54.4% contra 40.0%. O Claude Opus 4.8 está à frente no NL2Repo: 69.7% contra 58.0%. O GLM 5.3 escreve 197 tokens por segundo, o Claude Opus 4.8 escreve 59
- Benchmarks vencidos
- GLM 5.3: 11
- Claude Opus 4.8: 3
- Pontuação média
- GLM 5.3: 55.1%
- Claude Opus 4.8: 51.2%
- Velocidade de saída, tokens/s
- GLM 5.3: 197
- Claude Opus 4.8: 59
- Tempo até o primeiro token, s (escala logarítmica)
- GLM 5.3: 1.2
- Claude Opus 4.8: 1.3
- ExploitBench+14.4
- FrontierSWE+11.6
- DeepSWE v1.1+8.9
- Terminal-Bench 3.0+7.2
- AutomationBench+7.2
- PostTrainBench+6.9
- CyberGym+6.4
- HLE with tools+4.6
- ProgramBench+3.5
- Terminal-Bench 2.1+3.2
- Agents' Last Exam+2.8
- Toolathlon Verified−3.2
- SWE-Marathon v1.1−6.3
- NL2Repo−11.7
Melhor modelo por caso de uso
Pontuação média do GLM 5.3 e de 4 outros modelos por caso de uso
Código
?Média de 4 testes- 1GLM 5.374.4%
- 2DeepSeek V4 Pro73.8%
- 3Kimi K373.5%
- 4Claude Opus 4.872.7%
- 5Qwen 3.8 Max69.4%
Agentes
?Média de 2 testes- 1Kimi K352.0%
- 2Claude Opus 4.851.0%
- 3GLM 5.350.8%
- 4DeepSeek V4 Pro49.9%
- 5Qwen 3.8 Max49.8%
Trabalho intelectual
?AutomationBench- 1GLM 5.348.2%
- 2Kimi K346.7%
- 3DeepSeek V4 Pro43.2%
- 4Claude Opus 4.841.0%
- 5Qwen 3.8 Max39.8%
Raciocínio
?HLE with tools- 1GLM 5.362.5%
- 2DeepSeek V4 Pro60.0%
- 3Kimi K359.8%
- 4Claude Opus 4.857.9%
- 5Qwen 3.8 Max56.2%
Benchmarks do GLM 5.3
Compare o GLM 5.3 com 4 outros modelos em 14 benchmarks que medem código, agentes, trabalho intelectual e raciocínio
Código
- Terminal-Bench 2.1?GLM 5.388.2%Kimi K388.3%DeepSeek V4 Pro87.9%Qwen 3.8 Max86.6%Claude Opus 4.885.0%88.2%−0.1
- Terminal-Bench 3.0?GLM 5.328.3%Kimi K317.4%DeepSeek V4 Pro—Qwen 3.8 Max—Claude Opus 4.821.1%28.3%+7.2
- DeepSWE v1.1?GLM 5.366.9%Kimi K367.5%DeepSeek V4 Pro62.7%Qwen 3.8 Max56.6%Claude Opus 4.858.0%66.9%−0.6
- NL2Repo?GLM 5.358.0%Kimi K358.0%DeepSeek V4 Pro61.1%Qwen 3.8 Max55.9%Claude Opus 4.869.7%58.0%−11.7
- ProgramBench?GLM 5.319.0%Kimi K317.5%DeepSeek V4 Pro—Qwen 3.8 Max10.5%Claude Opus 4.815.5%19.0%+1.5
- FrontierSWE?GLM 5.378.1%Kimi K3—DeepSeek V4 Pro—Qwen 3.8 Max—Claude Opus 4.866.5%78.1%+11.6
- SWE-Marathon v1.1?GLM 5.342.5%Kimi K348.1%DeepSeek V4 Pro—Qwen 3.8 Max—Claude Opus 4.848.8%42.5%−6.3
- PostTrainBench?GLM 5.339.8%Kimi K332.0%DeepSeek V4 Pro—Qwen 3.8 Max—Claude Opus 4.832.9%39.8%+6.9
- CyberGym?GLM 5.384.5%Kimi K380.0%DeepSeek V4 Pro83.3%Qwen 3.8 Max78.5%Claude Opus 4.878.1%84.5%+1.2
- ExploitBench?GLM 5.354.4%Kimi K332.2%DeepSeek V4 Pro—Qwen 3.8 Max28.8%Claude Opus 4.840.0%54.4%+14.4
Agentes
- Toolathlon Verified?GLM 5.373.0%Kimi K376.5%DeepSeek V4 Pro74.1%Qwen 3.8 Max72.5%Claude Opus 4.876.2%73.0%−3.5
- Agents' Last Exam?GLM 5.328.5%Kimi K327.6%DeepSeek V4 Pro25.7%Qwen 3.8 Max27.0%Claude Opus 4.825.7%28.5%+0.9
Trabalho intelectual
- AutomationBench?GLM 5.348.2%Kimi K346.7%DeepSeek V4 Pro43.2%Qwen 3.8 Max39.8%Claude Opus 4.841.0%48.2%+1.5
Raciocínio
- HLE with tools?GLM 5.362.5%Kimi K359.8%DeepSeek V4 Pro60.0%Qwen 3.8 Max56.2%Claude Opus 4.857.9%62.5%+2.5
Fontes: Z.ai, GLM-5.3: código de ponta e capacidades de cibersegurança (14/08/2026), Z.ai, ficha do GLM-5.3 no Hugging Face, Artificial Analysis, GLM-5.3
Velocidade do GLM 5.3
A velocidade de saída é a rapidez com que o modelo escreve (tokens por segundo, quanto maior, melhor). O tempo até o primeiro token é quanto você espera até a resposta começar (quanto menor, melhor)
Velocidade de saída e tempo até o primeiro token de 35 modelos
?Percentil| Modelos | Velocidade de saída, tokens/s (escala logarítmica) | Tempo até o primeiro token, s (escala logarítmica) |
|---|---|---|
| GPT-6 Luna | 143 | 2.4 |
| GPT-6.1 Terra | 75 | 4.3 |
| GPT-6.1 Sol | 58 | 2.9 |
| GPT-6 Astra | 48 | 3.2 |
| Claude Opus 5.5 | 88 | 1.9 |
| Claude Opus 5 | 54 | 2.6 |
| Claude Opus 4.8 | 59 | 1.3 |
| Claude Fable 5.2 | 84 | 2.3 |
| Claude Sonnet 5.5 | 102 | 1 |
| Claude 5 Sonnet | 215 | 10.5 |
| Claude Sonnet 4.6 | 220 | 10.8 |
| Claude Haiku 5.5 | 167 | 2.1 |
| Gemini 4 Carbon | 169 | 29.5 |
| Gemini 4 Argon | 91 | 6 |
| Gemini 3.8 Flash | 203 | 7.5 |
| Gemini 3 Pro | 270 | 11.2 |
| Grok 4.7 | 81 | 8.9 |
| Grok 4.6 | 290 | 32 |
| Qwen 3.8 Max | 81 | 30.6 |
| DeepSeek V4 Pro | 144 | 1.1 |
| DeepSeek V4.1 Flash | 422 | 2.2 |
| Mistral Large 4 | 226 | 8.6 |
| Hy4 | 214 | 37.7 |
| ERNIE 5.5 Flash | 405 | 2.7 |
| Muse Wonder | 980 | 8.7 |
| Muse Spark | 1129 | 6.2 |
| Kimi K3.1 Pro | 340 | 7.4 |
| Kimi K3 | 338 | 5.9 |
| GLM 5.3 | 197 | 1.2 |
| Flint | 194 | 12.3 |
| Llama 4 | 81 | 0.7 |
| Claude 4.5 Haiku | 162 | 0.9 |
| MiniMax M3 | 169 | 4.5 |
| MiniMax M3.1 Flash | 656 | 7.2 |
| Kimi K2.7 Code | 455 | 3.6 |
Teste de digitação
Todos os modelos escrevem a mesma resposta. O teste espera o tempo do modelo até o primeiro token, depois imprime o texto na velocidade de saída do modelo e mostra o tempo total
- GLM 5.3197 tokens/s1.2 s até o primeiro token
- Kimi K3338 tokens/s5.9 s até o primeiro token
- DeepSeek V4 Pro144 tokens/s1.1 s até o primeiro token
- Qwen 3.8 Max81 tokens/s30.6 s até o primeiro token
Fonte: Overchat AI, 2026-11-11
Veja como o GLM 5.3 responde
Exemplos de respostas do GLM 5.3 a 3 prompts: Achar falhas de segurança, Escrever um script de shell e Escrever um postmortem. Cada resposta é a saída do modelo, sem edições
Revise esta rota de login em Flask em busca de problemas de segurança. Liste cada problema em uma linha e depois me dê a rota corrigida. ```python @app.route("/login", methods=["POST"]) def login(): user = request.form["user"] pw = request.form["password"] row = db.execute(f"SELECT id, password FROM users WHERE name = '{user}'").fetchone() if row and row[1] == pw: session["uid"] = row[0] return redirect(request.args.get("next", "/")) return "Wrong user or password: " + user, 401 ```
GLM 5.3Problemas encontrados:
- Injeção de SQL — a f-string interpola
userdiretamente na consulta; use consultas parametrizadas (?/placeholders). - Senhas em texto puro — a comparação
row[1] == pwassume senha sem hash; usecheck_password_hash(egenerate_password_hashno cadastro). - Open redirect —
request.args.get("next")aceita URLs absolutas comohttps://evil.compara phishing; valide que é um caminho relativo interno. - XSS refletido — a resposta ecoa
userde volta e o Flask entrega strings retornadas comotext/html, então<script>no campo executa no navegador. - Sem proteção CSRF — o POST de login não exige token CSRF.
- Sem limite de tentativas — nada impede força bruta contra senhas (rate limiting).
- Fixação de sessão — o
uidé gravado sem limpar a sessão anterior; chamesession.clear()antes. - Comparação não constante em tempo —
==na senha permite ataque de timing (resolvido de graça comcheck_password_hash).
Rota corrigida:
from urllib.parse import urlparse

from flask import request, session, redirect
from werkzeug.security import check_password_hash

@app.route("/login", methods=["POST"])
def login():
    user = request.form.get("user", "")
    pw = request.form.get("password", "")

    # Consulta parametrizada — elimina injeção de SQL
    row = db.execute(
        "SELECT id, password_hash FROM users WHERE name = ?", (user,)
    ).fetchone()

    if row and check_password_hash(row[1], pw):  # hash + comparação em tempo constante
        session.clear()                          # evita fixação de sessão
        session["uid"] = row[0]

        # "next" só pode ser caminho relativo deste site (bloqueia open redirect,
        # inclusive "//evil.com", que é URL absoluta)
        next_url = request.args.get("next", "/")
        p = urlparse(next_url)
        if (not next_url.startswith("/") or next_url.startswith("//")
                or p.netloc or p.scheme):
            next_url = "/"
        return redirect(next_url)

    # Mensagem genérica, sem ecoar a entrada do usuário (elimina o XSS)
    return "Wrong user or password", 401
Notas complementares (fora do trecho, mas essenciais):
- Ative CSRF globalmente com
CSRFProtect(app)do Flask-WTF e inclua{{ csrf_token() }}no formulário. - Adicione rate limiting, ex.:
@limiter.limit("5 per minute")com Flask-Limiter. - Configure um
SECRET_KEYforte e aleatório (senão as sessões assinadas podem ser forjadas). - No cadastro de usuários, armazene
generate_password_hash(senha), nunca a senha em claro. - Se o banco não for SQLite, troque o
?pelo placeholder correto (ex.:%sno PostgreSQL/MySQL).
Escreva um script bash que mostre os 10 maiores arquivos dentro de uma pasta que eu passar como argumento, ignorando node_modules e .git, com os tamanhos em formato legível. Seja breve e depois explique cada comando em uma linha.
GLM 5.3#!/bin/bash
du -ah "$1" 2>/dev/null \
| grep -vE 'node_modules|\.git/' \
| sort -rh \
| head -n 10Explicação de cada comando:
du -ah "$1"— lista arquivos e diretórios com tamanhos humanos recursivamente a partir do argumento$1.2>/dev/null— descarta mensagens de erro (ex.: permissão negada).grep -vE 'node_modules|\.git/'— remove linhas que contenhamnode_modulesou caminhos dentro de.git.sort -rh— ordena numericamente (-n) interpretando sufixos como K, M, G (-h), em ordem reversa (maior primeiro).head -n 10— mostra apenas as 10 primeiras linhas.
Dica: se quiser só arquivos (sem diretórios), troque o grep por um filtro de arquivos com find:
find "$1" -type f -not -path '*/node_modules/*' -not -path '*/.git/*' \
-exec du -h {} + | sort -rh | head -n 10Transforme estas anotações em um postmortem de incidente curto, com resumo, linha do tempo, causa raiz e três ações: checkout fora do ar das 14:02 às 14:41 UTC; um deploy às 13:58 mudou o timeout do cliente de pagamento de 10s para 1s; a latência p95 do provedor de pagamento é de 1,8s; os erros subiram para 62%; rollback às 14:37; cerca de 1.900 pedidos falharam.
GLM 5.3Postmortem de Incidente: Indisponibilidade do Checkout
Duração: 39 minutos (14:02–14:41 UTC) Severidade: Alta | Status: Resolvido
Resumo
Um deploy às 13:58 UTC alterou o timeout do cliente de pagamento de 10s para 1s, abaixo da latência p95 do provedor (1,8s). Como resultado, o checkout ficou fora do ar entre 14:02 e 14:41 UTC, com a taxa de erros chegando a 62% e aproximadamente 1.900 pedidos falhando. Um rollback às 14:37 restaurou o serviço.
Linha do Tempo (UTC)
| Horário | Evento |
|---|---|
| 13:58 | Deploy em produção altera timeout do cliente de pagamento de 10s → 1s |
| 14:02 | Início dos erros no checkout; taxa de erros dispara |
| 14:02–14:37 | Erros chegam a 62%; ~1.900 pedidos falham; monitoramento e diagnóstico |
| 14:37 | Rollback do deploy |
| 14:41 | Taxa de erros normalizada; checkout operacional |
Causa Raiz
O deploy reduziu o timeout do cliente de pagamento para 1s, valor abaixo da latência p95 do provedor de pagamento (1,8s). Isso fez com que uma grande fração das requisições válidas fosse abortada antes de receber resposta, gerando falhas em cascata no checkout. A mudança foi liberada sem validação contra métricas reais de latência do provedor e sem rollout gradual.
Ações
- Restaurar e proteger o timeout: reverter o timeout para 10s e definir seu valor com base em dados reais (p99 do provedor + margem), documentando a justificativa no código.
- Gate de deploy: implementar verificação automática que bloqueia mudanças de configuração críticas que conflitem com dependências conhecidas (ex.: timeout < p95 de latência de serviços externos).
- Rollout gradual + alerta de erro: exigir deploy canário para o checkout e configurar alerta que dispare quando a taxa de erros exceder um limiar (ex.: 5%), reduzindo o tempo de detecção.
Impacto: ~1.900 pedidos perdidos | Tempo de detecção: 4 min | Tempo de restauração: 39 min
Mais prompts para testar com o GLM 5.3
Em que o GLM 5.3 se destaca
Agentes de código e tarefas longas
O GLM 5.3 assume trabalhos de código que levam horas, de uma correção em toda a base de código a um recurso novo com testes. Ele marca 66,9% no DeepSWE e 28,3% no Terminal-Bench 3.0, à frente do Kimi K3 e do Claude Opus 4.8
Revisões de segurança
O GLM 5.3 encontra vulnerabilidades em código real e explica como corrigi-las. Ele marca 84,5% no CyberGym e já encontrou 2.436 vulnerabilidades em 269 projetos reais, algumas com décadas de idade
Fluxos de trabalho entre apps
O GLM 5.3 planeja e executa fluxos de trabalho de empresas que movem dados entre apps, com 48,2% no AutomationBench, a maior pontuação entre os modelos com que é comparado
Relatórios e documentos
Dê ao GLM 5.3 anotações, números e documentos, e ele devolve um relatório, um plano ou uma revisão. Ele tem 1.769 pontos no GDPval-AA, um teste de trabalho real de dezenas de profissões, o maior da sua comparação
Como usar o GLM 5.3 na Overchat AI
Use o chat do topo desta página ou o app da Overchat AI na web, no iOS ou no Android
- 01
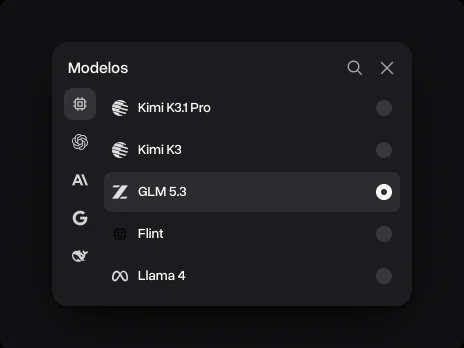
Escolha o GLM 5.3
Ele já vem selecionado no chat desta página. No app da Overchat AI, abra a lista de modelos ao lado do campo de mensagem e selecione o GLM 5.3
- 02
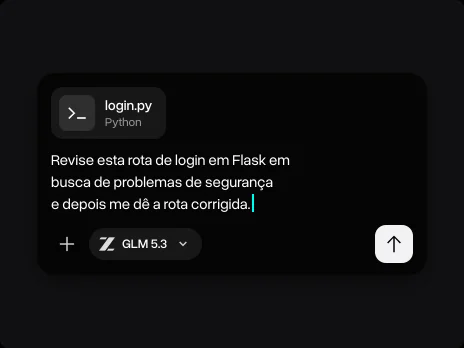
Anexe seu código ou um arquivo
Adicione código, um documento, uma planilha ou um print e escreva o que você precisa: o resultado, o formato e o que deve continuar igual
- 03
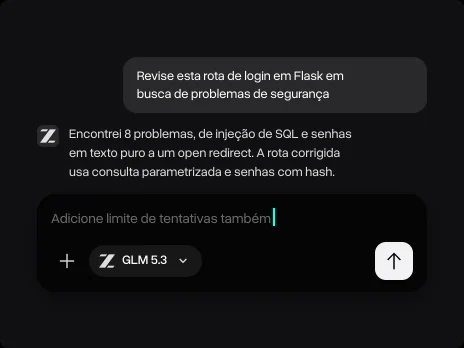
Continue no mesmo chat
Faça outra pergunta, peça testes ou uma versão mais curta, ou troque de modelo sem perder a conversa
Por que usar o GLM 5.3 na Overchat AI
Uma conta para chat, imagens e vídeo, em todos os dispositivos
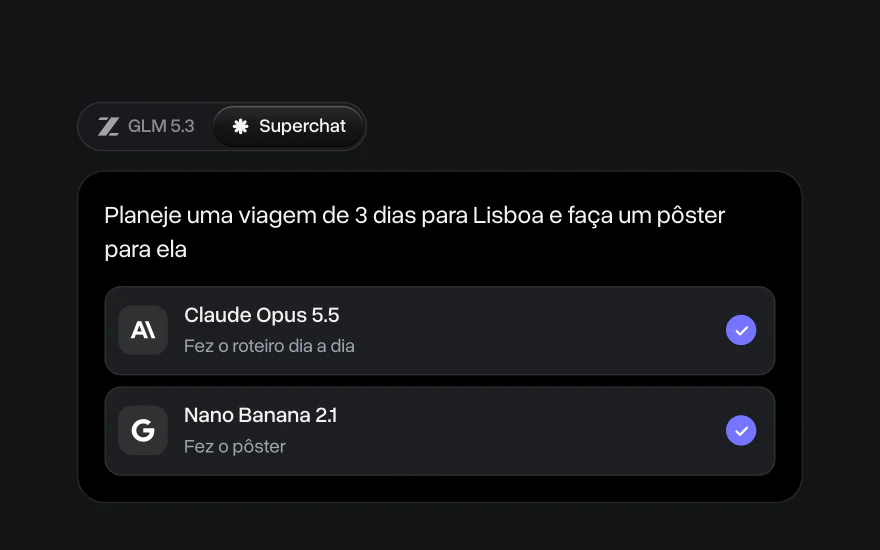
Agente de IA Superchat
O Superchat Agent envia sua mensagem automaticamente para o modelo mais adequado à tarefa. Ele gera imagens e vídeos, usa as ferramentas de IA da Overchat AI e aprende com suas interações para melhorar com o tempo
Converse com imagens e arquivos
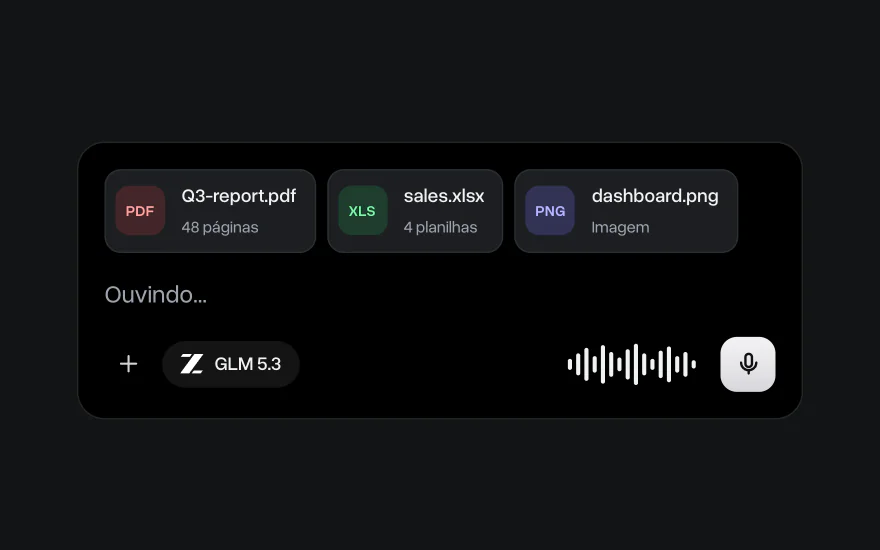
Envie PDFs, planilhas, código e prints e pergunte ao GLM 5.3 sobre eles. Você também pode ditar a mensagem em vez de digitar
Vá além do texto
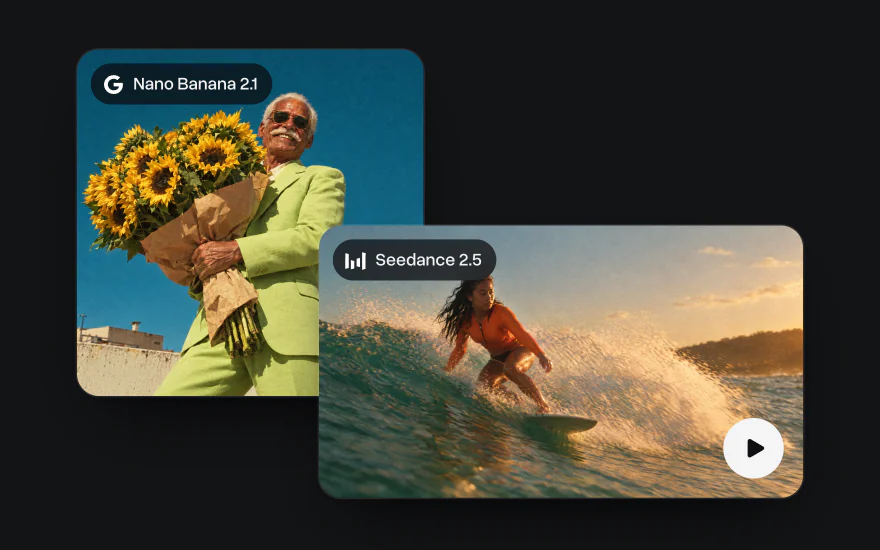
Gere imagens com Nano Banana e GPT Image e vídeos com Seedance e Kling na mesma conta, com os mesmos créditos do chat
Na web e no iPhone
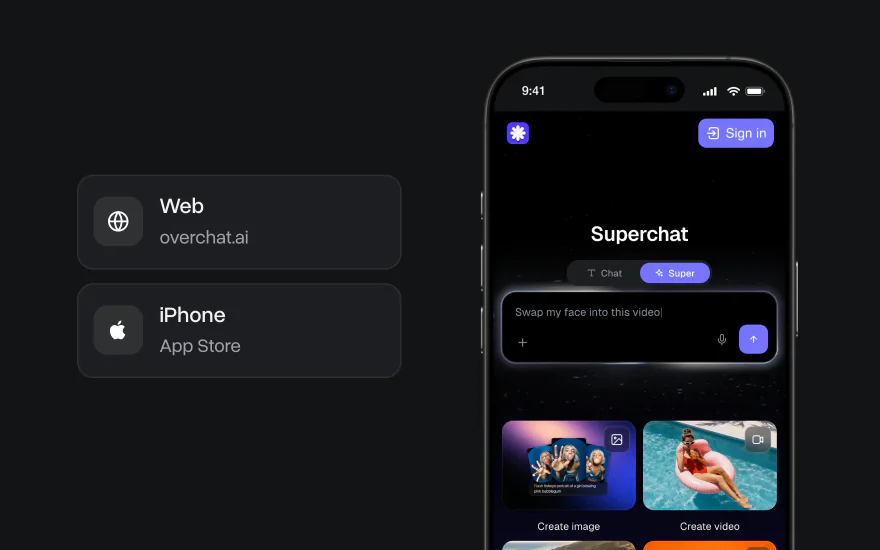
Comece um chat no notebook e termine no celular. O app da Overchat AI tem os mesmos modelos, e seus chats ficam em uma única conta em todos os dispositivos
Conheça outros modelos
Os modelos marcados como Em breve estão chegando à Overchat AI; os outros já estão disponíveis


Saiba mais sobre modelos de IA

Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder
Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder em três tarefas de programação. Veja benchmarks, velocidade e como usar
Muse Wonder vs Muse Spark: testamos o novo modelo da Meta
Comparamos o Muse Wonder e o Muse Spark 1.3 em lógica, escrita e programação. Veja benchmarks e qual modelo da Meta é melhor
10 melhores plataformas de IA tudo-em-um em 2026: por que uma assinatura de IA vale mais que várias
Compare as 10 melhores plataformas de IA tudo-em-um em 2026: preços, planos gratuitos e os modelos mais recentes, do Overchat AI ao Poe e ao Krater



