


Sobre o Muse Wonder
O Muse Wonder é o modelo Muse mais capaz da Meta, feito para agentes, trabalho intelectual e código. Ele lê texto, imagens, vídeo, áudio e PDFs, guarda até 1 milhão de tokens em uma conversa e continua trabalhando em uma tarefa difícil, tentando outros caminhos antes de desistir
O Muse Wonder marca 68,1% no AutomationBench, à frente do GPT-6.1 Terra, com 60,2%, e 30,6% no GDP.pdf, um dos dez melhores resultados entre todos os modelos em perguntas sobre PDFs profissionais longos. Quando não sabe a resposta de uma pergunta de conhecimento, ele diz isso em vez de inventar em 79,1% dos casos
Na Overchat AI, o Muse Wonder está no mesmo chat que o Muse Spark, o Claude e o GPT-6, então você pode perguntar a ele, anexar um arquivo e trocar de modelo sem começar de novo
- Modalidades
- Intelligence Index?
- 44
- Janela de contexto?
- 1M de tokens
- Lançamento
- 12/10/2026
Muse Wonder vs outros modelos
O Muse Wonder está em 11º lugar no Artificial Analysis Intelligence Index entre 54 modelos
- 65
 Claude Fable 5.2
- 60
 Gemini 4 Carbon
- 59Claude Opus 5.5
- 55
 GPT-6.1 Sol
- 51GPT-6.1 Terra
- 50Gemini 4 Argon
- 46
 Kimi K3.1 Pro
- 44
 Muse Wonder
- 37Muse Spark
- 35
 Grok 4.7
- #9de 148 modelosGDP.pdfPerguntas sobre PDFs profissionais longos, com tabelas, gráficos e letras miúdas
- #11de 142 modelosSciCodeCódigo Python para computação científica
- #13de 111 modelosSem inventar fatosCom que frequência o modelo diz que não sabe em vez de inventar uma resposta
- #15de 150 modelosAutomationBenchFluxos de trabalho de empresas que um agente executa em vários apps
Fonte: Artificial Analysis
Compare o Muse Wonder
Muse Wonder vs Kimi K3.1 Pro
O Muse Wonder pontua mais que o Kimi K3.1 Pro em 3 de 7 benchmarks. A maior vantagem é no FrontierCode 2.0: 27.9% contra 25.5%. O Kimi K3.1 Pro está à frente no Terminal-Bench 4.0: 67.2% contra 52.0%. O Muse Wonder escreve 980 tokens por segundo, o Kimi K3.1 Pro escreve 340
- Benchmarks vencidos
- Muse Wonder: 3
- Kimi K3.1 Pro: 4
- Pontuação média
- Muse Wonder: 42.0%
- Kimi K3.1 Pro: 45.5%
- Velocidade de saída, tokens/s
- Muse Wonder: 980
- Kimi K3.1 Pro: 340
- Tempo até o primeiro token, s (escala logarítmica)
- Muse Wonder: 8.7
- Kimi K3.1 Pro: 7.4
- FrontierCode 2.0+2.4
- HLE-Diamond+1.7
- CritPt v2 Hard+1.0
- GDP.pdf−0.8
- AutomationBench−5.2
- Terminal-Bench-Science−8.6
- Terminal-Bench 4.0−15.2
Muse Wonder vs GPT-6.1 Terra
O Muse Wonder pontua mais que o GPT-6.1 Terra em 2 de 7 benchmarks. A maior vantagem é no AutomationBench: 68.1% contra 60.2%. O GPT-6.1 Terra está à frente no Terminal-Bench-Science: 57.6% contra 25.7%. O Muse Wonder escreve 980 tokens por segundo, o GPT-6.1 Terra escreve 75
- Benchmarks vencidos
- Muse Wonder: 2
- GPT-6.1 Terra: 5
- Pontuação média
- Muse Wonder: 42.0%
- GPT-6.1 Terra: 51.4%
- Velocidade de saída, tokens/s
- Muse Wonder: 980
- GPT-6.1 Terra: 75
- Tempo até o primeiro token, s (escala logarítmica)
- Muse Wonder: 8.7
- GPT-6.1 Terra: 4.3
- AutomationBench+7.9
- GDP.pdf+2.0
- Terminal-Bench 4.0−3.6
- HLE-Diamond−8.3
- FrontierCode 2.0−14.4
- CritPt v2 Hard−17.5
- Terminal-Bench-Science−31.9
Muse Wonder vs Grok 4.7
O Muse Wonder pontua mais que o Grok 4.7 em 6 de 7 benchmarks. A maior vantagem é no Terminal-Bench 4.0: 52.0% contra 25.8%. O Grok 4.7 está à frente no FrontierCode 2.0: 28.7% contra 27.9%. O Muse Wonder escreve 980 tokens por segundo, o Grok 4.7 escreve 81
- Benchmarks vencidos
- Muse Wonder: 6
- Grok 4.7: 1
- Pontuação média
- Muse Wonder: 42.0%
- Grok 4.7: 29.7%
- Velocidade de saída, tokens/s
- Muse Wonder: 980
- Grok 4.7: 81
- Tempo até o primeiro token, s (escala logarítmica)
- Muse Wonder: 8.7
- Grok 4.7: 8.9
- Terminal-Bench 4.0+26.2
- CritPt v2 Hard+17.0
- HLE-Diamond+15.8
- Terminal-Bench-Science+14.3
- GDP.pdf+10.6
- AutomationBench+2.5
- FrontierCode 2.0−0.8
Muse Wonder vs Muse Spark
O Muse Wonder pontua mais que o Muse Spark em 7 de 7 benchmarks. A maior vantagem é no Terminal-Bench 4.0: 52.0% contra 33.3%. O Muse Wonder escreve 980 tokens por segundo, o Muse Spark escreve 1129
- Benchmarks vencidos
- Muse Wonder: 7
- Muse Spark: 0
- Pontuação média
- Muse Wonder: 42.0%
- Muse Spark: 33.4%
- Velocidade de saída, tokens/s
- Muse Wonder: 980
- Muse Spark: 1129
- Tempo até o primeiro token, s (escala logarítmica)
- Muse Wonder: 8.7
- Muse Spark: 6.2
- Terminal-Bench 4.0+18.7
- Terminal-Bench-Science+14.7
- AutomationBench+10.2
- HLE-Diamond+5.3
- FrontierCode 2.0+4.8
- GDP.pdf+4.0
- CritPt v2 Hard+2.5
Melhor modelo por caso de uso
Pontuação média do Muse Wonder e de 4 outros modelos por caso de uso
Código
?Média de 3 testes- 1GPT-6.1 Terra51.8%
- 2Kimi K3.1 Pro42.3%
- 3Muse Wonder35.2%
- 4Muse Spark22.5%
- 5Grok 4.722.0%
Trabalho intelectual
?Média de 2 testes- 1Kimi K3.1 Pro52.3%
- 2Muse Wonder49.3%
- 3GPT-6.1 Terra44.4%
- 4Grok 4.742.8%
- 5Muse Spark42.3%
Raciocínio
?Média de 2 testes- 1GPT-6.1 Terra57.6%
- 2Muse Wonder44.8%
- 3Kimi K3.1 Pro43.4%
- 4Muse Spark40.9%
- 5Grok 4.728.4%
Benchmarks do Muse Wonder
Compare o Muse Wonder com 4 outros modelos em 7 benchmarks que medem código, trabalho intelectual e raciocínio
Código
- Terminal-Bench 4.0?Muse Wonder52.0%Kimi K3.1 Pro67.2%GPT-6.1 Terra55.6%Grok 4.725.8%Muse Spark33.3%52.0%−15.2
- FrontierCode 2.0?Muse Wonder27.9%Kimi K3.1 Pro25.5%GPT-6.1 Terra42.3%Grok 4.728.7%Muse Spark23.1%27.9%−14.4
- Terminal-Bench-Science?Muse Wonder25.7%Kimi K3.1 Pro34.3%GPT-6.1 Terra57.6%Grok 4.711.4%Muse Spark11.0%25.7%−31.9
Trabalho intelectual
- AutomationBench?Muse Wonder68.1%Kimi K3.1 Pro73.3%GPT-6.1 Terra60.2%Grok 4.765.6%Muse Spark57.9%68.1%−5.2
- GDP.pdf?Muse Wonder30.6%Kimi K3.1 Pro31.4%GPT-6.1 Terra28.6%Grok 4.720.0%Muse Spark26.6%30.6%−0.8
Raciocínio
- HLE-Diamond?Muse Wonder39.0%Kimi K3.1 Pro37.3%GPT-6.1 Terra47.3%Grok 4.723.2%Muse Spark33.7%39.0%−8.3
- CritPt v2 Hard?Muse Wonder50.5%Kimi K3.1 Pro49.5%GPT-6.1 Terra68.0%Grok 4.733.5%Muse Spark48.0%50.5%−17.5
Fontes: Meta, Introducing Muse Wonder (12/10/2026), Artificial Analysis, Muse Wonder e Muse Wonder Full
Velocidade do Muse Wonder
A velocidade de saída é a rapidez com que o modelo escreve (tokens por segundo, quanto maior, melhor). O tempo até o primeiro token é quanto você espera até a resposta começar (quanto menor, melhor)
Velocidade de saída e tempo até o primeiro token de 35 modelos
?Percentil| Modelos | Velocidade de saída, tokens/s (escala logarítmica) | Tempo até o primeiro token, s (escala logarítmica) |
|---|---|---|
| GPT-6 Luna | 143 | 2.4 |
| GPT-6.1 Terra | 75 | 4.3 |
| GPT-6.1 Sol | 58 | 2.9 |
| GPT-6 Astra | 48 | 3.2 |
| Claude Opus 5.5 | 88 | 1.9 |
| Claude Opus 5 | 54 | 2.6 |
| Claude Opus 4.8 | 59 | 1.3 |
| Claude Fable 5.2 | 84 | 2.3 |
| Claude Sonnet 5.5 | 102 | 1 |
| Claude 5 Sonnet | 215 | 10.5 |
| Claude Sonnet 4.6 | 220 | 10.8 |
| Claude Haiku 5.5 | 167 | 2.1 |
| Gemini 4 Carbon | 169 | 29.5 |
| Gemini 4 Argon | 91 | 6 |
| Gemini 3.8 Flash | 203 | 7.5 |
| Gemini 3 Pro | 270 | 11.2 |
| Grok 4.7 | 81 | 8.9 |
| Grok 4.6 | 290 | 32 |
| Qwen 3.8 Max | 81 | 30.6 |
| DeepSeek V4 Pro | 144 | 1.1 |
| DeepSeek V4.1 Flash | 422 | 2.2 |
| Mistral Large 4 | 226 | 8.6 |
| Hy4 | 214 | 37.7 |
| ERNIE 5.5 Flash | 405 | 2.7 |
| Muse Wonder | 980 | 8.7 |
| Muse Spark | 1129 | 6.2 |
| Kimi K3.1 Pro | 340 | 7.4 |
| Kimi K3 | 338 | 5.9 |
| GLM 5.3 | 197 | 1.2 |
| Flint | 194 | 12.3 |
| Llama 4 | 81 | 0.7 |
| Claude 4.5 Haiku | 162 | 0.9 |
| MiniMax M3 | 169 | 4.5 |
| MiniMax M3.1 Flash | 656 | 7.2 |
| Kimi K2.7 Code | 455 | 3.6 |
Teste de digitação
Todos os modelos escrevem a mesma resposta. O teste espera o tempo do modelo até o primeiro token, depois imprime o texto na velocidade de saída do modelo e mostra o tempo total
- Muse Wonder980 tokens/s8.7 s até o primeiro token
- Kimi K3.1 Pro340 tokens/s7.4 s até o primeiro token
- GPT-6.1 Terra75 tokens/s4.3 s até o primeiro token
- Grok 4.781 tokens/s8.9 s até o primeiro token
Fonte: Overchat AI, 2026-11-11
Veja como o Muse Wonder responde
Exemplos de respostas do Muse Wonder a 3 prompts: Achar o problema, Simular um pêndulo e Checar um fato. Cada resposta é a saída do modelo, sem edições
Os últimos seis meses da minha loja online: visitas 42 mil, 45 mil, 47 mil, 51 mil, 50 mil, 53 mil; pedidos 1.260, 1.280, 1.240, 1.230, 1.150, 1.140; reembolsos 38, 41, 52, 66, 71, 80. Encontre os dois maiores problemas e sugira uma solução para cada, em uma tabela curta. Responda em português.
Muse Wonder| Problema | Evidência nos 6 meses | Solução sugerida |
|---|---|---|
| 1. Queda na conversão | Visitas subiram 26% (42 mil → 53 mil), mas pedidos caíram 9,5% (1.260 → 1.140). Conversão: 3,0% → 2,15%. | Auditar a origem do tráfego novo (pode ser pouco qualificado) e otimizar página do produto e checkout: velocidade, frete, preço e formas de pagamento. |
| 2. Aumento dos reembolsos | Reembolsos mais que dobraram: 38 → 80. Taxa sobre pedidos: 3,0% → 7,0%. | Levantar o motivo principal (defeito, atraso ou produto diferente do anunciado) e corrigir a causa: melhorar descrição/fotos, controle de qualidade e prazo de entrega. |
Escreva uma função em Python que simule um pêndulo amortecido com o método RK4 e devolva o ângulo ao longo do tempo. Use menos de 40 linhas e explique a escolha do passo de tempo em uma frase. Responda em português.
Muse Wonderimport numpy as np
def pendulo_amortecido(theta0=0.5, omega0=0.0, tempo_final=10.0, dt=0.01,
comprimento=1.0, amortecimento=0.1, g=9.81):
def derivadas(y):
theta, omega = y
return np.array([omega, -amortecimento * omega - (g / comprimento) * np.sin(theta)])
n = int(tempo_final / dt) + 1
tempo = np.linspace(0, tempo_final, n)
y = np.array([theta0, omega0], dtype=float)
angulo = np.empty(n)
angulo[0] = y[0]
for i in range(1, n):
k1 = derivadas(y)
k2 = derivadas(y + dt / 2 * k1)
k3 = derivadas(y + dt / 2 * k2)
k4 = derivadas(y + dt * k3)
y += (dt / 6) * (k1 + 2 * k2 + 2 * k3 + k4)
angulo[i] = y[0]
return tempo, anguloEscolhi dt=0,01 s porque ele é muito menor que o período natural do pêndulo (cerca de 2 s para comprimento=1 m), garantindo boa precisão ao RK4 com custo computacional baixo.
Quem foi a primeira pessoa a andar na Lua, e quem foi a 13ª? Se alguma parte da pergunta não tiver resposta real, diga isso em vez de chutar.
Muse WonderA primeira pessoa a andar na Lua foi Neil Armstrong, da missão Apollo 11, em julho de 1969.
A 13ª pessoa não existe — pelo menos até hoje, apenas 12 pessoas andaram na Lua:
- Neil Armstrong (Apollo 11)
- Buzz Aldrin (Apollo 11)
- Pete Conrad (Apollo 12)
- Alan Bean (Apollo 12)
- Alan Shepard (Apollo 14)
- Edgar Mitchell (Apollo 14)
- David Scott (Apollo 15)
- James Irwin (Apollo 15)
- John Young (Apollo 16)
- Charles Duke (Apollo 16)
- Eugene Cernan (Apollo 17)
- Harrison Schmitt (Apollo 17)
A última foi em 1972, na Apollo 17, então não há uma 13ª pessoa para indicar.
Mais prompts para testar com o Muse Wonder
Em que o Muse Wonder se destaca
Agentes e fluxos de trabalho
O Muse Wonder executa fluxos de trabalho em apps de vendas, suporte e finanças, com 68,1% no AutomationBench, à frente do GPT-6.1 Terra e do Grok 4.7
Relatórios e PDFs longos
O Muse Wonder responde a perguntas sobre PDFs profissionais longos, com tabelas, gráficos e letras miúdas, com 30,6% no GDP.pdf, um dos dez melhores resultados entre todos os modelos
Respostas confiáveis
O Muse Wonder diz quando não sabe: em 79,1% das perguntas de conhecimento que não consegue responder, ele admite isso em vez de inventar um fato
Código e ciência
O Muse Wonder escreve código científico, com 60,3% no SciCode, e conclui tarefas difíceis no terminal, com 52,0% no Terminal-Bench 4.0
Como usar o Muse Wonder na Overchat AI
Use o chat do topo desta página ou o app da Overchat AI na web, no iOS ou no Android
- 01
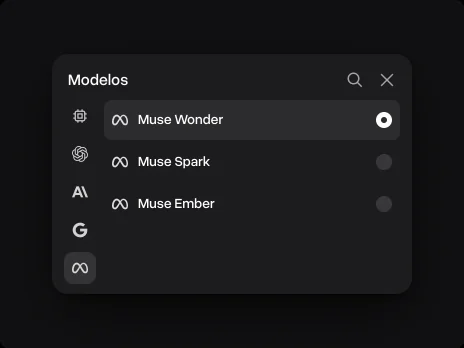
Escolha o Muse Wonder
Ele já vem selecionado no chat desta página. No app da Overchat AI, abra a lista de modelos ao lado do campo de mensagem e selecione o Muse Wonder
- 02
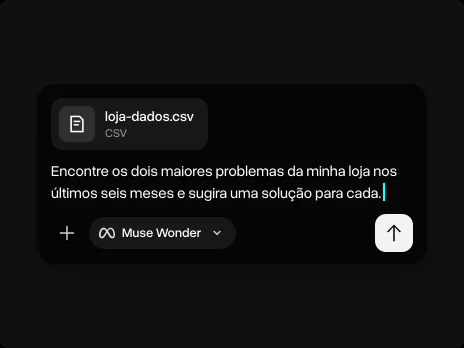
Anexe seu código ou um arquivo
Adicione código, um documento, uma planilha ou um print e escreva o que você precisa: o resultado, o formato e o que deve continuar igual
- 03
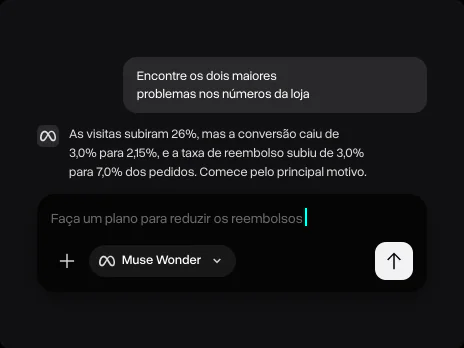
Continue no mesmo chat
Faça outra pergunta, peça testes ou uma versão mais curta, ou troque de modelo sem perder a conversa
Por que usar o Muse Wonder na Overchat AI
Uma conta para chat, imagens e vídeo, em todos os dispositivos
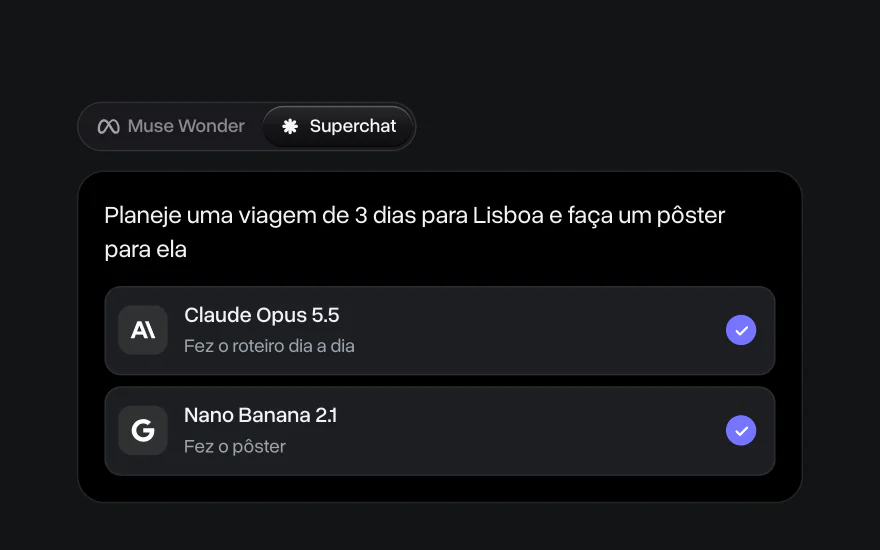
Agente de IA Superchat
O Superchat Agent envia sua mensagem automaticamente para o modelo mais adequado à tarefa. Ele gera imagens e vídeos, usa as ferramentas de IA da Overchat AI e aprende com suas interações para melhorar com o tempo
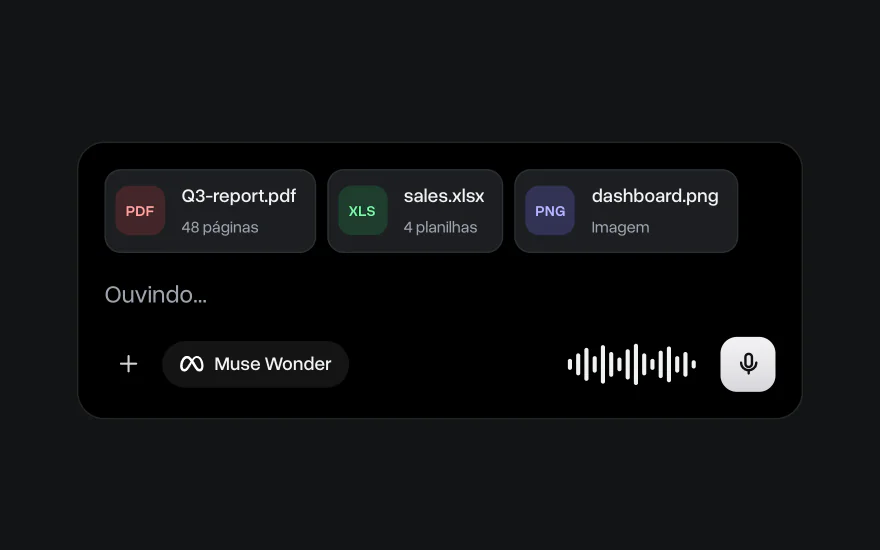
Converse com imagens e arquivos
Envie PDFs, planilhas, código e prints e pergunte ao Muse Wonder sobre eles. Você também pode ditar a mensagem em vez de digitar
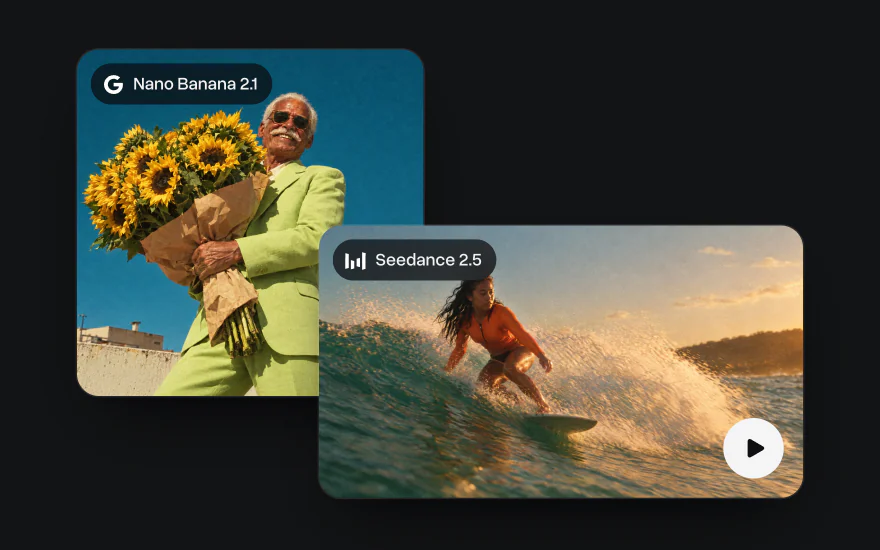
Vá além do texto
Gere imagens com Nano Banana e GPT Image e vídeos com Seedance e Kling na mesma conta, com os mesmos créditos do chat
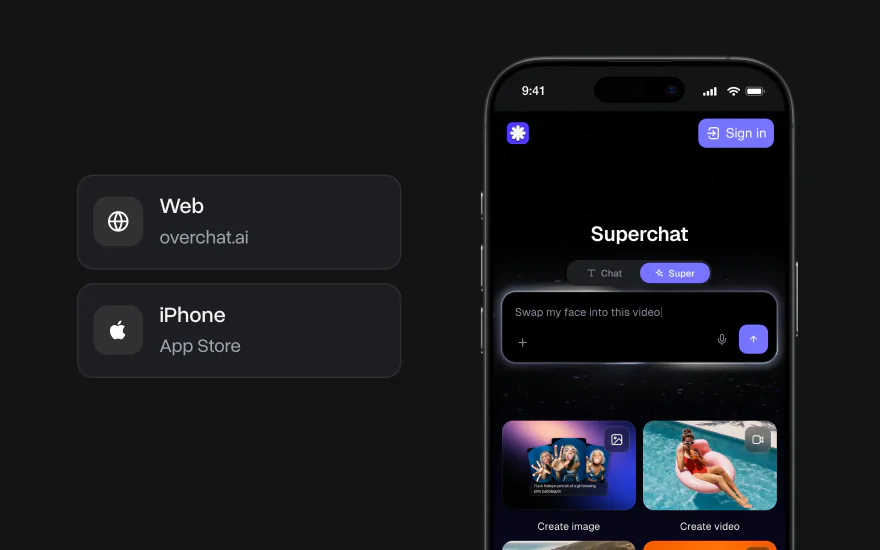
Na web e no iPhone
Comece um chat no notebook e termine no celular. O app da Overchat AI tem os mesmos modelos, e seus chats ficam em uma única conta em todos os dispositivos
Modelos Meta na Overchat AI
Compare 4 modelos Meta na Overchat AI por velocidade de saída, tempo até o primeiro token e preço de uma mensagem
Muse WonderEsta páginaLlama 4Fonte: Overchat AI, 2026-11-11
Conheça outros modelos
Os modelos marcados como Em breve estão chegando à Overchat AI; os outros já estão disponíveis


Saiba mais sobre modelos de IA

Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder
Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder em três tarefas de programação. Veja benchmarks, velocidade e como usar
Muse Wonder vs Muse Spark: testamos o novo modelo da Meta
Comparamos o Muse Wonder e o Muse Spark 1.3 em lógica, escrita e programação. Veja benchmarks e qual modelo da Meta é melhor
10 melhores plataformas de IA tudo-em-um em 2026: por que uma assinatura de IA vale mais que várias
Compare as 10 melhores plataformas de IA tudo-em-um em 2026: preços, planos gratuitos e os modelos mais recentes, do Overchat AI ao Poe e ao Krater



