


Sobre o Qwen 3.8 Max
O Qwen 3.8 Max é o modelo Qwen mais capaz da Alibaba, feito para código, pesquisa e tarefas longas. Ele tem 2,4 trilhões de parâmetros, dos quais 95 bilhões trabalham em cada token, lê até 1 milhão de tokens de texto, imagens e vídeo em uma conversa e pensa antes de responder. Esta é a atualização de 2 de setembro, com código e agentes mais fortes
O Qwen 3.8 Max marca 88,8% no Terminal-Bench 2.1, o quinto entre 140 modelos, e 92,8% no GPQA Diamond, um teste de perguntas de ciência de pós-graduação. Ele consegue ficar dias em uma só tarefa: refez do zero os experimentos de um artigo científico em cerca de cinco dias e depois encontrou um método melhor que o do próprio artigo
Na Overchat AI, o Qwen 3.8 Max está no mesmo chat que o Claude Opus 5.5, o GPT-6 e o DeepSeek, então você pode comparar respostas e trocar de modelo sem começar de novo
- Modalidades
- Intelligence Index?
- 33,7
- Janela de contexto?
- 1M de tokens
- Lançamento
- 02/09/2026
Qwen 3.8 Max vs outros modelos
O Qwen 3.8 Max está em 19º lugar no Artificial Analysis Intelligence Index entre 54 modelos
- 59.1
 Claude Opus 5.5
- 54.6
 GPT-6.1 Sol
- 54.5Claude Sonnet 5.5
- 50.4
 Gemini 4 Argon
- 46.5
 Kimi K3.1 Pro
- 35.5
 Grok 4.7
- 34.6
 Hy4
- 33.7
 Qwen 3.8 Max
- 32.6
 DeepSeek V4.1 Flash
- 31.7
 GLM 5.3
- #5de 140 modelosTerminal-Bench 2.1Tarefas de código que um agente conclui no terminal
- #6de 131 modelosτ-Bench BankingPedidos de clientes que um agente atende com as ferramentas e regras de um banco
- #12de 166 modelosGDPval-AATarefas de trabalhos reais, avaliadas em comparação com o trabalho de especialistas
- #15de 325 modelosGPQA DiamondPerguntas de pós-graduação em física, química e biologia
Fonte: Artificial Analysis
Compare o Qwen 3.8 Max
Qwen 3.8 Max vs GLM 5.3
O Qwen 3.8 Max pontua mais que o GLM 5.3 em 5 de 11 benchmarks. A maior vantagem é no Terminal-Bench 2.1: 88.8% contra 83.9%. O GLM 5.3 está à frente no SciCode: 59.0% contra 52.1%. O Qwen 3.8 Max escreve 81 tokens por segundo, o GLM 5.3 escreve 197
- Benchmarks vencidos
- Qwen 3.8 Max: 5
- GLM 5.3: 6
- Pontuação média
- Qwen 3.8 Max: 50.8%
- GLM 5.3: 52.0%
- Velocidade de saída, tokens/s
- Qwen 3.8 Max: 81
- GLM 5.3: 197
- Tempo até o primeiro token, s (escala logarítmica)
- Qwen 3.8 Max: 30.6
- GLM 5.3: 1.2
- Terminal-Bench 2.1+4.9
- Terminal-Bench-Science+2.4
- GPQA Diamond+1.1
- Humanity's Last Exam+0.8
- AA-LCR+0.6
- CritPt−1.4
- τ-Bench Banking−2.5
- AA-Omniscience−2.8
- Terminal-Bench 4.0−3.0
- AutomationBench−6.0
- SciCode−6.9
Qwen 3.8 Max vs DeepSeek V4.1 Flash
O Qwen 3.8 Max pontua mais que o DeepSeek V4.1 Flash em 1 de 8 benchmarks. A maior vantagem é no Terminal-Bench 4.0: 38.9% contra 33.8%. O DeepSeek V4.1 Flash está à frente no AutomationBench: 66.6% contra 56.2%. O Qwen 3.8 Max escreve 81 tokens por segundo, o DeepSeek V4.1 Flash escreve 422
- Benchmarks vencidos
- Qwen 3.8 Max: 1
- DeepSeek V4.1 Flash: 7
- Pontuação média
- Qwen 3.8 Max: 41.2%
- DeepSeek V4.1 Flash: 44.9%
- Velocidade de saída, tokens/s
- Qwen 3.8 Max: 81
- DeepSeek V4.1 Flash: 422
- Tempo até o primeiro token, s (escala logarítmica)
- Qwen 3.8 Max: 30.6
- DeepSeek V4.1 Flash: 2.2
- Terminal-Bench 4.0+5.1
- Humanity's Last Exam−0.2
- Terminal-Bench-Science−1.0
- AA-LCR−2.4
- SciCode−3.8
- CritPt−6.3
- AA-Omniscience−10.1
- AutomationBench−10.4
- Terminal-Bench 2.1—
- τ-Bench Banking—
- GPQA Diamond—
Qwen 3.8 Max vs Grok 4.7
O Qwen 3.8 Max pontua mais que o Grok 4.7 em 3 de 8 benchmarks. A maior vantagem é no Terminal-Bench 4.0: 38.9% contra 25.8%. O Grok 4.7 está à frente no AA-Omniscience: 42.7% contra 29.5%. O Qwen 3.8 Max escreve 81 tokens por segundo, o Grok 4.7 escreve 81
- Benchmarks vencidos
- Qwen 3.8 Max: 3
- Grok 4.7: 5
- Pontuação média
- Qwen 3.8 Max: 41.2%
- Grok 4.7: 42.5%
- Velocidade de saída, tokens/s
- Qwen 3.8 Max: 81
- Grok 4.7: 81
- Tempo até o primeiro token, s (escala logarítmica)
- Qwen 3.8 Max: 30.6
- Grok 4.7: 8.9
- Terminal-Bench 4.0+13.1
- AA-LCR+3.6
- Terminal-Bench-Science+0.5
- Humanity's Last Exam0.0
- CritPt0.0
- SciCode−5.3
- AutomationBench−9.4
- AA-Omniscience−13.2
- Terminal-Bench 2.1—
- τ-Bench Banking—
- GPQA Diamond—
Melhor modelo por caso de uso
Pontuação média do Qwen 3.8 Max e de 3 outros modelos por caso de uso
Código
?Média de 3 testes- 1GLM 5.336.8%
- 2Qwen 3.8 Max34.3%
- 3DeepSeek V4.1 Flash34.2%
- 4Grok 4.731.5%
Trabalho intelectual
?Média de 3 testes- 1DeepSeek V4.1 Flash63.0%
- 2Grok 4.761.7%
- 3GLM 5.358.1%
- 4Qwen 3.8 Max55.3%
Raciocínio
?Média de 2 testes- 1DeepSeek V4.1 Flash33.6%
- 2GLM 5.330.7%
- 3Qwen 3.8 Max30.4%
- 4Grok 4.730.4%
Benchmarks do Qwen 3.8 Max
Compare o Qwen 3.8 Max com GLM 5.3, DeepSeek V4.1 Flash e Grok 4.7 em 11 benchmarks que medem código, agentes, trabalho intelectual e raciocínio
Código
- Terminal-Bench 4.0?Qwen 3.8 Max38.9%GLM 5.341.9%DeepSeek V4.1 Flash33.8%Grok 4.725.8%38.9%−3.0
- Terminal-Bench 2.1?Qwen 3.8 Max88.8%GLM 5.383.9%DeepSeek V4.1 Flash—Grok 4.7—88.8%+4.9
- SciCode?Qwen 3.8 Max52.1%GLM 5.359.0%DeepSeek V4.1 Flash55.9%Grok 4.757.4%52.1%−6.9
- Terminal-Bench-Science?Qwen 3.8 Max11.9%GLM 5.39.5%DeepSeek V4.1 Flash12.9%Grok 4.711.4%11.9%−1.0
Agentes
- τ-Bench Banking?Qwen 3.8 Max47.8%GLM 5.350.3%DeepSeek V4.1 Flash—Grok 4.7—47.8%−2.5
Trabalho intelectual
- AutomationBench?Qwen 3.8 Max56.2%GLM 5.362.2%DeepSeek V4.1 Flash66.6%Grok 4.765.6%56.2%−10.4
- AA-LCR?Qwen 3.8 Max80.3%GLM 5.379.7%DeepSeek V4.1 Flash82.7%Grok 4.776.7%80.3%−2.4
- AA-Omniscience?Qwen 3.8 Max29.5%GLM 5.332.3%DeepSeek V4.1 Flash39.6%Grok 4.742.7%29.5%−13.2
Raciocínio
- GPQA Diamond?Qwen 3.8 Max92.8%GLM 5.391.7%DeepSeek V4.1 Flash—Grok 4.7—92.8%+1.1
- Humanity's Last Exam?Qwen 3.8 Max43.1%GLM 5.342.3%DeepSeek V4.1 Flash43.3%Grok 4.743.1%43.1%−0.2
- CritPt?Qwen 3.8 Max17.7%GLM 5.319.1%DeepSeek V4.1 Flash24.0%Grok 4.717.7%17.7%−6.3
Fontes: Qwen, Qwen3.8-Max: um novo patamar para código e trabalho (03/08/2026), Qwen Cloud, registro de mudanças: qwen3.8-max-0902 (02/09/2026), Artificial Analysis, Qwen3.8 Max (0902)
Velocidade do Qwen 3.8 Max
A velocidade de saída é a rapidez com que o modelo escreve (tokens por segundo, quanto maior, melhor). O tempo até o primeiro token é quanto você espera até a resposta começar (quanto menor, melhor)
Velocidade de saída e tempo até o primeiro token de 35 modelos
?Percentil| Modelos | Velocidade de saída, tokens/s (escala logarítmica) | Tempo até o primeiro token, s (escala logarítmica) |
|---|---|---|
| GPT-6 Luna | 143 | 2.4 |
| GPT-6.1 Terra | 75 | 4.3 |
| GPT-6.1 Sol | 58 | 2.9 |
| GPT-6 Astra | 48 | 3.2 |
| Claude Opus 5.5 | 88 | 1.9 |
| Claude Opus 5 | 54 | 2.6 |
| Claude Opus 4.8 | 59 | 1.3 |
| Claude Fable 5.2 | 84 | 2.3 |
| Claude Sonnet 5.5 | 102 | 1 |
| Claude 5 Sonnet | 215 | 10.5 |
| Claude Sonnet 4.6 | 220 | 10.8 |
| Claude Haiku 5.5 | 167 | 2.1 |
| Gemini 4 Carbon | 169 | 29.5 |
| Gemini 4 Argon | 91 | 6 |
| Gemini 3.8 Flash | 203 | 7.5 |
| Gemini 3 Pro | 270 | 11.2 |
| Grok 4.7 | 81 | 8.9 |
| Grok 4.6 | 290 | 32 |
| Qwen 3.8 Max | 81 | 30.6 |
| DeepSeek V4 Pro | 144 | 1.1 |
| DeepSeek V4.1 Flash | 422 | 2.2 |
| Mistral Large 4 | 226 | 8.6 |
| Hy4 | 214 | 37.7 |
| ERNIE 5.5 Flash | 405 | 2.7 |
| Muse Wonder | 980 | 8.7 |
| Muse Spark | 1129 | 6.2 |
| Kimi K3.1 Pro | 340 | 7.4 |
| Kimi K3 | 338 | 5.9 |
| GLM 5.3 | 197 | 1.2 |
| Flint | 194 | 12.3 |
| Llama 4 | 81 | 0.7 |
| Claude 4.5 Haiku | 162 | 0.9 |
| MiniMax M3 | 169 | 4.5 |
| MiniMax M3.1 Flash | 656 | 7.2 |
| Kimi K2.7 Code | 455 | 3.6 |
Teste de digitação
Todos os modelos escrevem a mesma resposta. O teste espera o tempo do modelo até o primeiro token, depois imprime o texto na velocidade de saída do modelo e mostra o tempo total
- Qwen 3.8 Max81 tokens/s30.6 s até o primeiro token
- GLM 5.3197 tokens/s1.2 s até o primeiro token
- DeepSeek V4.1 Flash422 tokens/s2.2 s até o primeiro token
- Grok 4.781 tokens/s8.9 s até o primeiro token
Fonte: Overchat AI, 2026-11-11
Veja como o Qwen 3.8 Max responde
Exemplos de respostas do Qwen 3.8 Max a 3 prompts: Criar uma página de preços, Resolver um problema de física e Traduzir uma mensagem. Cada resposta é a saída do modelo, sem edições
Crie um único arquivo HTML com uma seção de preços de três planos e um seletor Mensal / Anual que muda os preços. Use CSS puro e poucas linhas de JavaScript, sem bibliotecas, com menos de 120 linhas. Textos da página em português.
Qwen 3.8 Max<!doctype html>
<html lang="pt-BR">
<head>
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1">
<title>Planos e Preços</title>
<style>
body{margin:0;font-family:system-ui,sans-serif;background:#f4f6fb;color:#182033;display:grid;place-items:center;min-height:100vh}
.precos{width:min(960px,92vw);text-align:center;padding:24px}
h1{margin:0 0 16px;font-size:clamp(1.6rem,3vw,2.4rem)}
.seletor{display:inline-flex;gap:6px;background:#e6eaf4;padding:6px;border-radius:999px;margin-bottom:24px}
.seletor button{border:0;background:transparent;padding:8px 18px;border-radius:999px;font:inherit;cursor:pointer;color:#4b5570}
.seletor button.ativo{background:#111c3d;color:#fff}
.planos{display:grid;grid-template-columns:repeat(auto-fit,minmax(220px,1fr));gap:16px;align-items:stretch}
.plano{background:#fff;border:1px solid #d8ddec;border-radius:16px;padding:24px;display:flex;flex-direction:column;gap:12px;box-shadow:0 10px 24px rgb(17 28 61 / 8%)}
.plano.destaque{outline:3px solid #4467e8;transform:translateY(-6px)}
.plano h2{margin:0;font-size:1.15rem}
.preco{margin:0;display:flex;justify-content:center;align-items:baseline;gap:4px}
.valor{font-size:2.2rem;font-weight:700}
.periodo{color:#66708a}
.descricao{margin:0;color:#5a6480;min-height:2.4em}
ul{margin:0;padding:0 0 0 1.1em;text-align:left;color:#3c455d;display:grid;gap:6px}
a{margin-top:auto;text-decoration:none;background:#111c3d;color:#fff;padding:10px 14px;border-radius:10px}
.plano.destaque a{background:#4467e8}
.aviso{margin:18px 0 0;color:#2f7a45;font-weight:600}
</style>
</head>
<body>
<main class="precos">
<h1>Escolha seu plano</h1>
<div class="seletor" aria-label="Período de cobrança">
<button id="mensal" class="ativo" type="button">Mensal</button>
<button id="anual" type="button">Anual</button>
</div>
<section class="planos">
<article class="plano">
<h2>Básico</h2>
<p class="preco"><span class="valor" data-mensal="R$ 19" data-anual="R$ 15">R$ 19</span><span class="periodo">/mês</span></p>
<p class="descricao">Para quem está começando.</p>
<ul>
<li>1 usuário</li>
<li>5 GB de armazenamento</li>
<li>Suporte por e-mail</li>
</ul>
<a href="#">Assinar Básico</a>
</article>
<article class="plano destaque">
<h2>Profissional</h2>
<p class="preco"><span class="valor" data-mensal="R$ 39" data-anual="R$ 31">R$ 39</span><span class="periodo">/mês</span></p>
<p class="descricao">Ideal para equipes pequenas.</p>
<ul>
<li>5 usuários</li>
<li>50 GB de armazenamento</li>
<li>Suporte prioritário</li>
</ul>
<a href="#">Assinar Profissional</a>
</article>
<article class="plano">
<h2>Empresarial</h2>
<p class="preco"><span class="valor" data-mensal="R$ 79" data-anual="R$ 63">R$ 79</span><span class="periodo">/mês</span></p>
<p class="descricao">Recursos completos para escalar.</p>
<ul>
<li>Usuários ilimitados</li>
<li>500 GB de armazenamento</li>
<li>Atendimento dedicado</li>
</ul>
<a href="#">Assinar Empresarial</a>
</article>
</section>
<p id="aviso" class="aviso" hidden>Plano anual com desconto equivalente por mês.</p>
</main>
<script>
const botoes = document.querySelectorAll(".seletor button");
const valores = document.querySelectorAll(".valor");
const aviso = document.getElementById("aviso");
function trocar(modo) {
valores.forEach((v) => (v.textContent = v.dataset[modo]));
botoes.forEach((b) => b.classList.toggle("ativo", b.id === modo));
aviso.hidden = modo !== "anual";
}
botoes.forEach((b) => b.addEventListener("click", () => trocar(b.id)));
</script>
</body>
</html>Uma bola é chutada do chão a 20 m/s, com ângulo de 35° acima da horizontal. Desprezando a resistência do ar, qual altura ela atinge, quanto tempo fica no ar e a que distância cai? Mostre os passos de forma breve, com g = 9,81 m/s². Escreva as contas em texto simples, sem LaTeX.
Qwen 3.8 MaxDados:
- velocidade inicial: 20 m/s
- ângulo: 35° acima da horizontal
- g = 9,81 m/s²
Passo 1: separar as componentes da velocidade
vertical: 20 * sen(35°) = 20 * 0,5736 = 11,47 m/s
horizontal: 20 * cos(35°) = 20 * 0,8192 = 16,38 m/s
Passo 2: altura máxima
altura = (velocidade vertical)^2 / (2 * g)
altura = 11,47^2 / (2 * 9,81)
altura = 131,6 / 19,62
altura ≈ 6,71 m
Passo 3: tempo no ar
tempo de subida = 11,47 / 9,81 ≈ 1,17 s
tempo total = 2 * 1,17 ≈ 2,34 s
Passo 4: distância horizontal
distância = velocidade horizontal * tempo total
distância = 16,38 * 2,34
distância ≈ 38,3 m
Respostas:
- altura máxima: cerca de 6,71 m
- tempo no ar: cerca de 2,34 s
- distância alcançada: cerca de 38,3 m
Traduza esta mensagem para um cliente para inglês, espanhol e japonês, mantendo o tom simpático e educado: "Obrigado pelo seu pedido! Ele será enviado amanhã e deve chegar até sexta-feira. Se houver qualquer problema, é só responder a este e-mail que a gente resolve."
Qwen 3.8 MaxInglês (English):
“Thank you for your order! It will be shipped tomorrow and should arrive by Friday. If there’s any issue, just reply to this email and we’ll be happy to help.”
Espanhol (Español):
“¡Gracias por su pedido! Será enviado mañana y debería llegar antes del viernes. Si surge algún problema, solo responda a este correo y con gusto lo resolveremos.”
Japonês (日本語):
「ご注文いただきありがとうございます!明日発送予定で、金曜日までにお届けできる見込みです。もし何か問題がございましたら、このメールにご返信いただければ対応いたします。」
Mais prompts para testar com o Qwen 3.8 Max
Em que o Qwen 3.8 Max se destaca
Sites e apps
O Qwen 3.8 Max escreve código de front-end, páginas inteiras e apps pequenos a partir de um pedido simples e os corrige no mesmo chat. Ele marca 88,8% no Terminal-Bench 2.1, o quinto entre 140 modelos
Matemática e ciências
O Qwen 3.8 Max resolve problemas de física, química e matemática passo a passo, com 92,8% no GPQA Diamond, um teste de perguntas de ciência de pós-graduação
Textos em muitos idiomas
O Qwen 3.8 Max escreve, revisa e traduz em português, inglês, chinês, espanhol, japonês e dezenas de outros idiomas, mantendo o tom do original
Documentos longos
O Qwen 3.8 Max lê até 1 milhão de tokens de uma vez, cerca de 1.500 páginas, e responde perguntas sobre um relatório, um contrato ou uma base de código inteira, com 80,3% no AA-LCR
Como usar o Qwen 3.8 Max na Overchat AI
Use o chat do topo desta página ou o app da Overchat AI na web, no iOS ou no Android
- 01
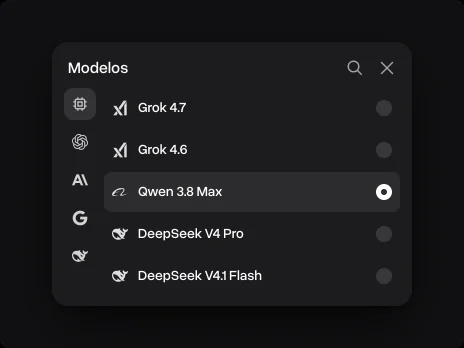
Escolha o Qwen 3.8 Max
Ele já vem selecionado no chat desta página. No app da Overchat AI, abra a lista de modelos ao lado do campo de mensagem e selecione o Qwen 3.8 Max
- 02
Escreva seu pedido
Cole seu texto ou código e escreva o que você precisa: o resultado, o formato e o que deve continuar igual
- 03
Continue no mesmo chat
Faça outra pergunta, peça testes ou uma versão mais curta, ou troque de modelo sem perder a conversa
Por que usar o Qwen 3.8 Max na Overchat AI
Uma conta para chat, imagens e vídeo, em todos os dispositivos
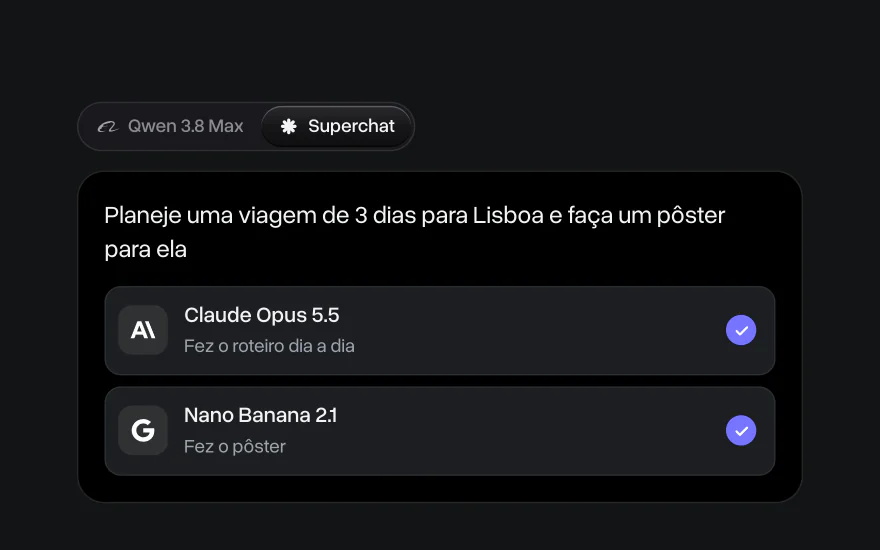
Agente de IA Superchat
O Superchat Agent envia sua mensagem automaticamente para o modelo mais adequado à tarefa. Ele gera imagens e vídeos, usa as ferramentas de IA da Overchat AI e aprende com suas interações para melhorar com o tempo
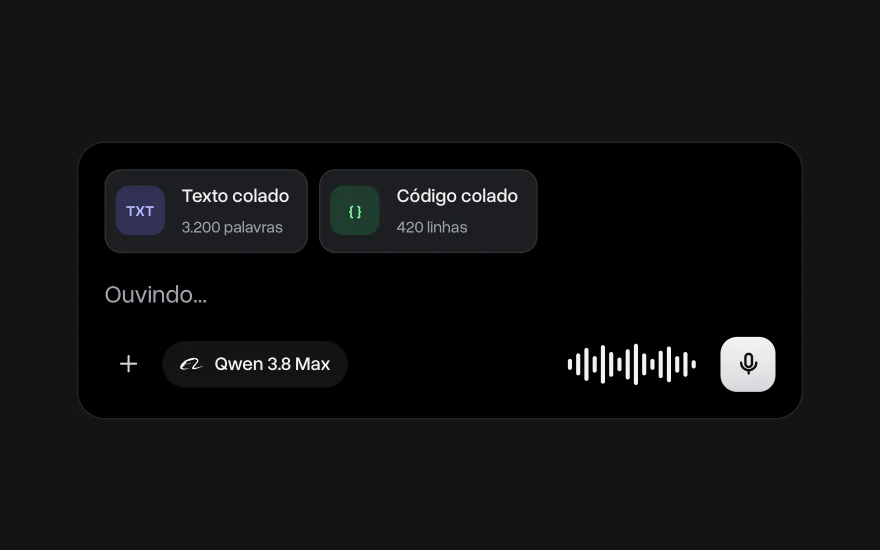
Cole textos longos e código
Cole um documento longo, um log ou um arquivo inteiro de código e pergunte ao Qwen 3.8 Max sobre ele. Você também pode ditar a mensagem em vez de digitar
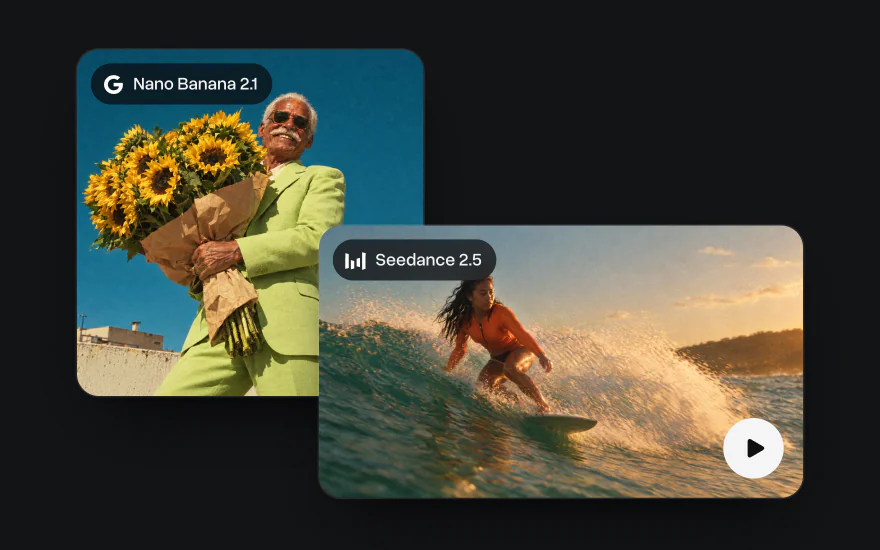
Vá além do texto
Gere imagens com Nano Banana e GPT Image e vídeos com Seedance e Kling na mesma conta, com os mesmos créditos do chat
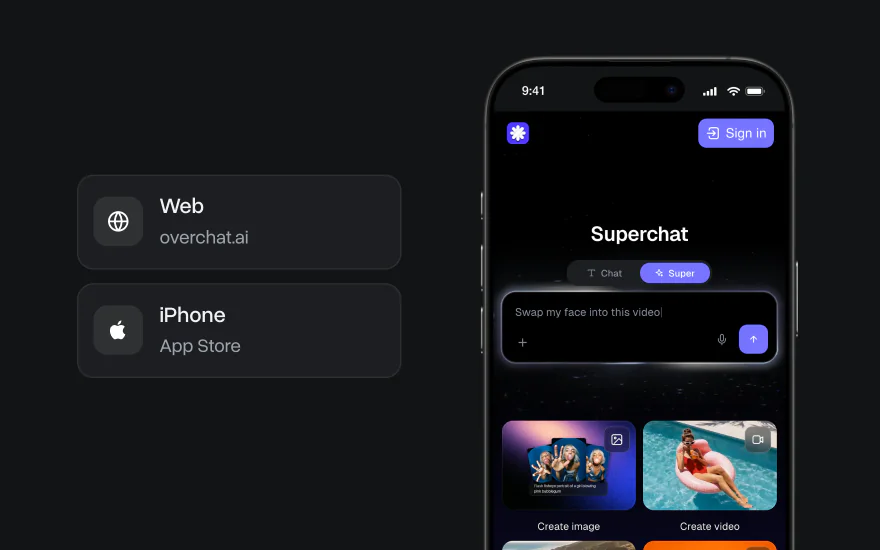
Na web e no iPhone
Comece um chat no notebook e termine no celular. O app da Overchat AI tem os mesmos modelos, e seus chats ficam em uma única conta em todos os dispositivos
Conheça outros modelos
Os modelos marcados como Em breve estão chegando à Overchat AI; os outros já estão disponíveis


Saiba mais sobre modelos de IA

Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder
Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder em três tarefas de programação. Veja benchmarks, velocidade e como usar
Muse Wonder vs Muse Spark: testamos o novo modelo da Meta
Comparamos o Muse Wonder e o Muse Spark 1.3 em lógica, escrita e programação. Veja benchmarks e qual modelo da Meta é melhor
10 melhores plataformas de IA tudo-em-um em 2026: por que uma assinatura de IA vale mais que várias
Compare as 10 melhores plataformas de IA tudo-em-um em 2026: preços, planos gratuitos e os modelos mais recentes, do Overchat AI ao Poe e ao Krater



