


Sobre o Grok 4.7
O Grok 4.7 é o modelo da xAI para código e trabalho intelectual, com cerca de 2,1 trilhões de parâmetros. Ele lê texto, imagens e arquivos, recebe até 500 mil tokens em uma conversa e trabalha em tarefas difíceis por horas, verificando o próprio trabalho antes de responder
O Grok 4.7 marca 64,0% no EEBench, um teste de engenharia elétrica, à frente do Claude Fable 5.1, com 56,4%, e do GPT-5.6 Sol, com 39,4%, e 19,6% no Harvey's Legal Agent Benchmark, o triplo dos 6,7% do Fable 5.1. Em código ele chega a 46,3% no CursorBench 4.0 e 71,0% no DeepSWE v1.1, contra 40,4% e 65,2% do Grok 4.6
Na Overchat AI, o Grok 4.7 trabalha no mesmo chat que o Claude, o GPT-6 e o Gemini, então você pode passar a mesma tarefa para outro modelo no meio da conversa
- Modalidades
- Intelligence Index?
- 35
- Janela de contexto?
- 500 mil tokens
- Lançamento
- 21/09/2026
Grok 4.7 vs outros modelos
O Grok 4.7 está em 41º lugar no Artificial Analysis Intelligence Index entre 54 modelos
- 65
 Claude Fable 5.2
- 60
 Gemini 4 Carbon
- 59Claude Opus 5.5
- 57
 GPT-6 Astra
- 55GPT-6.1 Sol
- 50
 Muse Wonder Full
- 46
 Kimi K3.1 Pro
- 44Muse Wonder
- 35
 Grok 4.7
- 33
 DeepSeek V4.1 Flash
- #5de 63 modelosAA-Omniscience Non-Hallucination RateCom que frequência o modelo diz que não sabe em vez de inventar uma resposta
- #9de 166 modelosGDPval-AATarefas de trabalhos reais, avaliadas em comparação com o trabalho de especialistas
- #19de 63 modelosAA-Omniscience AccuracyPerguntas de conhecimento respondidas corretamente
- #20de 136 modelosSciCodeCódigo Python para computação científica
Fonte: Artificial Analysis
Compare o Grok 4.7
Grok 4.7 vs Grok 4.6
O Grok 4.7 pontua mais que o Grok 4.6 em 6 de 6 benchmarks. A maior vantagem é no Terminal-Bench 4.0: 37.6% contra 20.3%. O Grok 4.7 escreve 81 tokens por segundo, o Grok 4.6 escreve 290
- Benchmarks vencidos
- Grok 4.7: 6
- Grok 4.6: 0
- Pontuação média
- Grok 4.7: 49.2%
- Grok 4.6: 40.5%
- Velocidade de saída, tokens/s
- Grok 4.7: 81
- Grok 4.6: 290
- Tempo até o primeiro token, s (escala logarítmica)
- Grok 4.7: 8.9
- Grok 4.6: 32.0
- Terminal-Bench 4.0+17.3
- EEBench+11.0
- HealthBench Professional+8.2
- CursorBench 4.0+5.9
- DeepSWE v1.1+5.8
- Harvey's Legal Agent Benchmark+3.8
Grok 4.7 vs GPT-5.6 Sol
O Grok 4.7 pontua mais que o GPT-5.6 Sol em 4 de 6 benchmarks. A maior vantagem é no EEBench: 64.0% contra 39.4%. O GPT-5.6 Sol está à frente no HealthBench Professional: 60.5% contra 56.7%
- Benchmarks vencidos
- Grok 4.7: 4
- GPT-5.6 Sol: 2
- Pontuação média
- Grok 4.7: 49.2%
- GPT-5.6 Sol: 42.4%
- EEBench+24.6
- Harvey's Legal Agent Benchmark+17.1
- CursorBench 4.0+4.6
- Terminal-Bench 4.0+0.3
- DeepSWE v1.1−1.7
- HealthBench Professional−3.8
Grok 4.7 vs Claude Fable 5.1
O Grok 4.7 pontua mais que o Claude Fable 5.1 em 3 de 6 benchmarks. A maior vantagem é no Harvey's Legal Agent Benchmark: 19.6% contra 6.7%. O Claude Fable 5.1 está à frente no Terminal-Bench 4.0: 57.9% contra 37.6%
- Benchmarks vencidos
- Grok 4.7: 3
- Claude Fable 5.1: 3
- Pontuação média
- Grok 4.7: 49.2%
- Claude Fable 5.1: 50.8%
- Harvey's Legal Agent Benchmark+12.9
- EEBench+7.6
- DeepSWE v1.1+1.0
- HealthBench Professional−5.4
- CursorBench 4.0−5.5
- Terminal-Bench 4.0−20.3
Melhor modelo por caso de uso
Pontuação média do Grok 4.7 e de 3 outros modelos por caso de uso
Código
?Média de 3 testes- 1Claude Fable 5.159.9%
- 2Grok 4.751.6%
- 3GPT-5.6 Sol50.6%
- 4Grok 4.642.0%
Trabalho intelectual
?Média de 3 testes- 1Grok 4.746.8%
- 2Claude Fable 5.141.7%
- 3Grok 4.639.1%
- 4GPT-5.6 Sol34.1%
Benchmarks do Grok 4.7
Compare o Grok 4.7 com Grok 4.6, GPT-5.6 Sol e Claude Fable 5.1 em 6 benchmarks que medem código e trabalho intelectual
Código
- CursorBench 4.0?Grok 4.746.3%Grok 4.640.4%GPT-5.6 Sol41.7%Claude Fable 5.151.8%46.3%−5.5
- DeepSWE v1.1?Grok 4.771.0%Grok 4.665.2%GPT-5.6 Sol72.7%Claude Fable 5.170.0%71.0%−1.7
- Terminal-Bench 4.0?Grok 4.737.6%Grok 4.620.3%GPT-5.6 Sol37.3%Claude Fable 5.157.9%37.6%−20.3
Trabalho intelectual
- EEBench?Grok 4.764.0%Grok 4.653.0%GPT-5.6 Sol39.4%Claude Fable 5.156.4%64.0%+7.6
- Harvey's Legal Agent Benchmark?Grok 4.719.6%Grok 4.615.8%GPT-5.6 Sol2.5%Claude Fable 5.16.7%19.6%+3.8
- HealthBench Professional?Grok 4.756.7%Grok 4.648.5%GPT-5.6 Sol60.5%Claude Fable 5.162.1%56.7%−5.4
Velocidade do Grok 4.7
A velocidade de saída é a rapidez com que o modelo escreve (tokens por segundo, quanto maior, melhor). O tempo até o primeiro token é quanto você espera até a resposta começar (quanto menor, melhor)
Velocidade de saída e tempo até o primeiro token de 35 modelos
?Percentil| Modelos | Velocidade de saída, tokens/s (escala logarítmica) | Tempo até o primeiro token, s (escala logarítmica) |
|---|---|---|
| GPT-6 Luna | 143 | 2.4 |
| GPT-6.1 Terra | 75 | 4.3 |
| GPT-6.1 Sol | 58 | 2.9 |
| GPT-6 Astra | 48 | 3.2 |
| Claude Opus 5.5 | 88 | 1.9 |
| Claude Opus 5 | 54 | 2.6 |
| Claude Opus 4.8 | 59 | 1.3 |
| Claude Fable 5.2 | 84 | 2.3 |
| Claude Sonnet 5.5 | 102 | 1 |
| Claude 5 Sonnet | 215 | 10.5 |
| Claude Sonnet 4.6 | 220 | 10.8 |
| Claude Haiku 5.5 | 167 | 2.1 |
| Gemini 4 Carbon | 169 | 29.5 |
| Gemini 4 Argon | 91 | 6 |
| Gemini 3.8 Flash | 203 | 7.5 |
| Gemini 3 Pro | 270 | 11.2 |
| Grok 4.7 | 81 | 8.9 |
| Grok 4.6 | 290 | 32 |
| Qwen 3.8 Max | 81 | 30.6 |
| DeepSeek V4 Pro | 144 | 1.1 |
| DeepSeek V4.1 Flash | 422 | 2.2 |
| Mistral Large 4 | 226 | 8.6 |
| Hy4 | 214 | 37.7 |
| ERNIE 5.5 Flash | 405 | 2.7 |
| Muse Wonder | 980 | 8.7 |
| Muse Spark | 1129 | 6.2 |
| Kimi K3.1 Pro | 340 | 7.4 |
| Kimi K3 | 338 | 5.9 |
| GLM 5.3 | 197 | 1.2 |
| Flint | 194 | 12.3 |
| Llama 4 | 81 | 0.7 |
| Claude 4.5 Haiku | 162 | 0.9 |
| MiniMax M3 | 169 | 4.5 |
| MiniMax M3.1 Flash | 656 | 7.2 |
| Kimi K2.7 Code | 455 | 3.6 |
Teste de digitação
Todos os modelos escrevem a mesma resposta. O teste espera o tempo do modelo até o primeiro token, depois imprime o texto na velocidade de saída do modelo e mostra o tempo total
- Grok 4.781 tokens/s8.9 s até o primeiro token
- Grok 4.6290 tokens/s32.0 s até o primeiro token
Fonte: Overchat AI, 2026-11-11
Veja como o Grok 4.7 responde
Exemplos de respostas do Grok 4.7 a 3 prompts: Escolher um circuito, Script de backup e Roteiro de apresentação. Cada resposta é a saída do modelo, sem edições
Quero alimentar uma fita de LED de 12 V que consome 2 A a partir de uma fonte de 24 V. Devo usar um resistor, um regulador linear ou um conversor buck? Explique com os números. Responda em português.
Grok 4.7Use um conversor buck. Resistor e regulador linear desperdiçam a mesma potência em calor e não são adequados para 2 A contínuos.
A fita pede 12 V × 2 A = 24 W. A fonte entrega 24 V, então qualquer solução linear tem de “jogar fora” 12 V.
Resistor em série
- Queda: 24 − 12 = 12 V
- R = 12 V / 2 A = 6 Ω
- Calor: 12 V × 2 A = 24 W (eficiência 50 %)
Além do resistor enorme e quente, a tensão na fita só fica em 12 V se a corrente for exatamente 2 A. Se a fita consumir menos (trecho menor, LEDs apagados), a tensão sobe e pode queimar a fita. Não use.
Regulador linear
- Dissipação: (24 − 12) × 2 A = 24 W
- Eficiência: 12/24 = 50 %
O 7812 clássico não aguenta 2 A nem 24 W. Mesmo um regulador de potência exigiria dissipador grande (na prática, dezenas de °C/W a menos, ventilação). Viável só como gambiarra; ruim no dia a dia.
Conversor buck (24 V → 12 V)
Com ~90 % de eficiência (típico de um módulo decente):
- Potência de entrada: 24 W / 0,9 ≈ 27 W
- Corrente na fonte de 24 V: 27 / 24 ≈ 1,1 A
- Calor no conversor: ~2–3 W, fácil de dissipar
Escolha um módulo com margem (3 A ou mais contínuos, por exemplo baseado em XL4015 ou um buck síncrono), ajuste a saída para 12,0 V sem carga e confira com a fita ligada, e use fiação grossa o bastante para 2 A.
Escreva um script bash que faça backup de uma pasta em um arquivo .tar.gz com a data no nome, mantenha só os 7 backups mais recentes e registre cada execução em um log. Depois mostre como rodá-lo todas as noites às 2h com o cron. Responda em português.
Grok 4.7Script de backup com rotação e log, e o agendamento no cron.
#!/usr/bin/env bash
# backup.sh — compacta uma pasta em .tar.gz, guarda só os 7 mais recentes e registra no log.
set -euo pipefail

# Ajuste estes caminhos
ORIGEM="/caminho/da/pasta"
DESTINO="/caminho/dos/backups"
LOG="/var/log/backup-pasta.log"
MANTER=7

mkdir -p "$DESTINO"
touch "$LOG"

DATA="$(date +%Y-%m-%d_%H%M%S)"
NOME="$(basename "$ORIGEM")"
ARQUIVO="${DESTINO}/${NOME}_${DATA}.tar.gz"

log() {
  echo "$(date '+%Y-%m-%d %H:%M:%S') $*" >> "$LOG"
}

if [[ ! -d "$ORIGEM" ]]; then
  log "ERRO: pasta de origem não existe: $ORIGEM"
  exit 1
fi

log "INICIO backup de $ORIGEM -> $ARQUIVO"

if tar -czf "$ARQUIVO" -C "$(dirname "$ORIGEM")" "$NOME"; then
  log "OK arquivo criado: $ARQUIVO ($(du -h "$ARQUIVO" | cut -f1))"
else
  log "ERRO ao criar o arquivo tar"
  exit 1
fi

# Remove os mais antigos, mantendo só os MANTER mais recentes
mapfile -t ANTIGOS < <(ls -1t "${DESTINO}/${NOME}_"*.tar.gz 2>/dev/null | tail -n +"$((MANTER + 1))" || true)
for f in "${ANTIGOS[@]:-}"; do
  [[ -n "$f" ]] || continue
  rm -f "$f"
  log "REMOVIDO backup antigo: $f"
done

log "FIM backups restantes: $(ls -1 "${DESTINO}/${NOME}_"*.tar.gz 2>/dev/null | wc -l)"
Como usar:
chmod +x /usr/local/bin/backup.sh
# teste manual
/usr/local/bin/backup.sh
Cron todas as noites às 2h (usuário que tem permissão de ler a pasta e escrever no destino e no log):
crontab -eLinha a incluir:
0 2 * * * /usr/local/bin/backup.sh0 2 * * * significa minuto 0, hora 2, todos os dias. O cron usa o fuso do sistema. Se o script precisar de caminhos absolutos (já usa) e de um ambiente mínimo, isso basta; não dependa de variáveis do seu shell interativo.
Confira com crontab -l e, depois da primeira noite, o arquivo em $DESTINO e as linhas em $LOG.
Monte o roteiro de uma apresentação de 6 slides para investidores de um app que ajuda quem divide apartamento a dividir o aluguel e as contas: um título e três tópicos curtos para cada slide.
Grok 4.7Slide 1 — O problema
- Dividir aluguel e contas ainda é manual, confuso e gerador de atrito.
- Quem mora junto perde tempo com planilhas, prints e cobranças.
- Atrasos e desentendimentos desgastam a convivência.
Slide 2 — A solução
- App que calcula, divide e cobra aluguel e contas automaticamente.
- Cada morador vê o que deve, o que pagou e o que falta.
- Menos conversa chata, mais transparência no dia a dia.
Slide 3 — Como funciona
- Cadastro do imóvel, dos moradores e das regras de divisão.
- Inclusão de aluguel, luz, água, internet e despesas extras.
- Cobrança, lembretes e histórico em um só lugar.
Slide 4 — Mercado
- Moradia compartilhada cresce entre jovens, estudantes e profissionais.
- A dor é recorrente: todo mês há contas para dividir.
- O hábito de pagar pelo celular já está consolidado.
Slide 5 — Modelo de negócio
- Plano gratuito para divisões simples.
- Assinatura para grupos com mais recursos e automações.
- Receita também via parceiros de pagamento e serviços da casa.
Slide 6 — Por que investir agora
- Produto claro, uso mensal e alta retenção potencial.
- Expansão para repúblicas, coliving e imóveis geridos.
- Capital para aquisição, produto e parcerias de pagamento.
Mais prompts para testar com o Grok 4.7
Em que o Grok 4.7 se destaca
Código na sua base
O Grok 4.7 corrige bugs e cria funcionalidades em bases de código reais e roda no Cursor e no Grok Build. Ele marca 71,0% no DeepSWE v1.1 e 46,3% no CursorBench 4.0
Engenharia elétrica
O Grok 4.7 dimensiona circuitos, escolhe componentes e confere o consumo de energia, mostrando as contas. Ele marca 64,0% no EEBench, à frente do Claude Fable 5.1 e do GPT-5.6 Sol
Trabalho jurídico e de escritório
O Grok 4.7 redige documentos, apresentações e revisões de contratos. Ele marca 19,6% no Harvey's Legal Agent Benchmark, contra 6,7% do Claude Fable 5.1 e 2,5% do GPT-5.6 Sol
Tarefas longas em várias etapas
O Grok 4.7 trabalha em uma tarefa difícil por horas e verifica o próprio trabalho antes de responder. Ele quase dobra a pontuação do Grok 4.6 no Terminal-Bench 4.0, de 20,3% para 37,6%
Como usar o Grok 4.7 na Overchat AI
Use o chat do topo desta página ou o app da Overchat AI na web, no iOS ou no Android
- 01
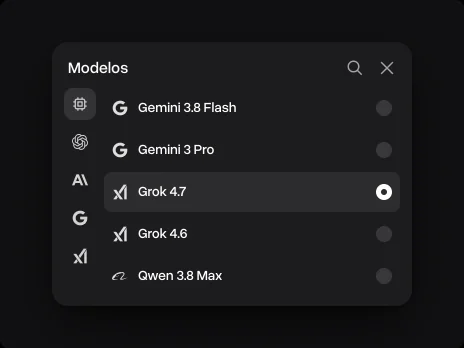
Escolha o Grok 4.7
Ele já vem selecionado no chat desta página. No app da Overchat AI, abra a lista de modelos ao lado do campo de mensagem e selecione o Grok 4.7
- 02
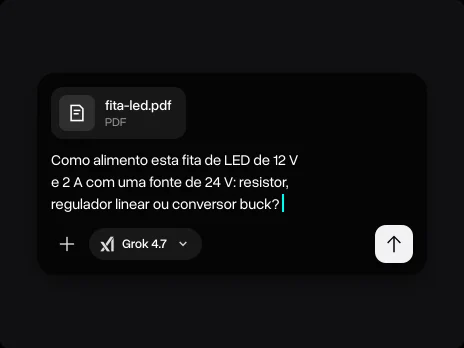
Anexe seu código ou um arquivo
Adicione código, um documento, uma planilha ou um print e escreva o que você precisa: o resultado, o formato e o que deve continuar igual
- 03
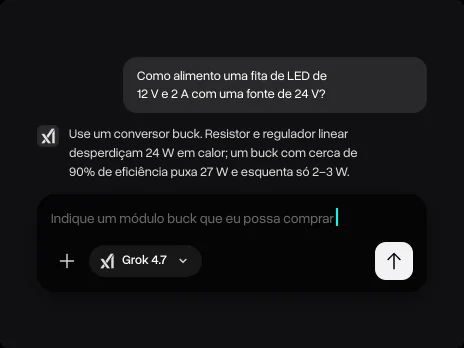
Continue no mesmo chat
Faça outra pergunta, peça testes ou uma versão mais curta, ou troque de modelo sem perder a conversa
Por que usar o Grok 4.7 na Overchat AI
Uma conta para chat, imagens e vídeo, em todos os dispositivos
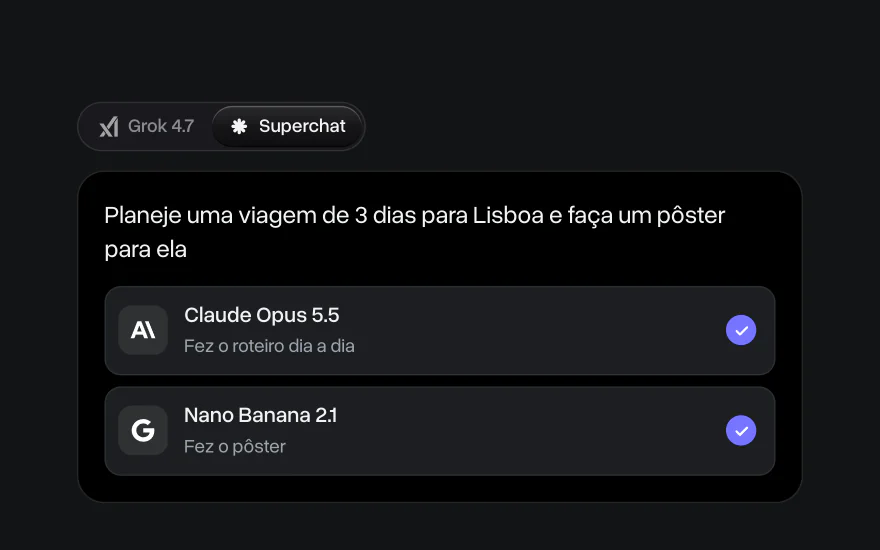
Agente de IA Superchat
O Superchat Agent envia sua mensagem automaticamente para o modelo mais adequado à tarefa. Ele gera imagens e vídeos, usa as ferramentas de IA da Overchat AI e aprende com suas interações para melhorar com o tempo
Converse com imagens e arquivos
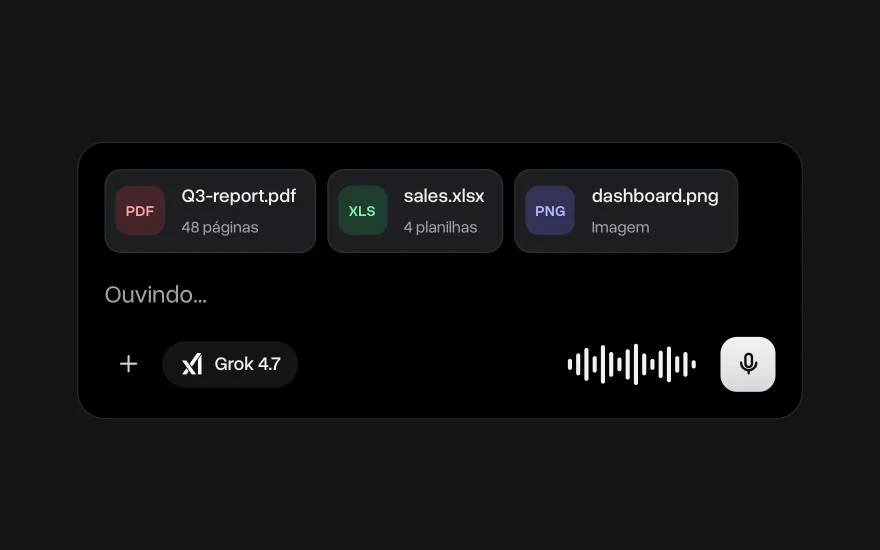
Envie PDFs, planilhas, código e prints e pergunte ao Grok 4.7 sobre eles. Você também pode ditar a mensagem em vez de digitar
Vá além do texto
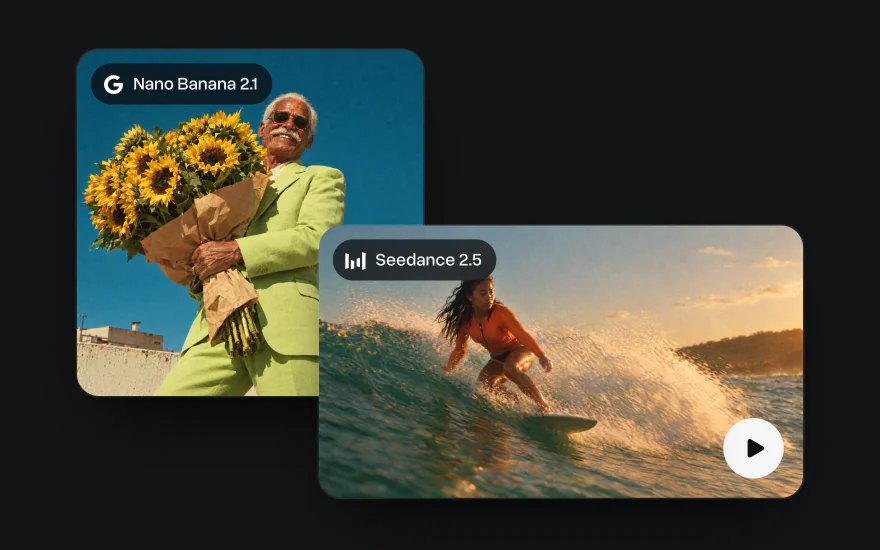
Gere imagens com Nano Banana e GPT Image e vídeos com Seedance e Kling na mesma conta, com os mesmos créditos do chat
Na web e no iPhone
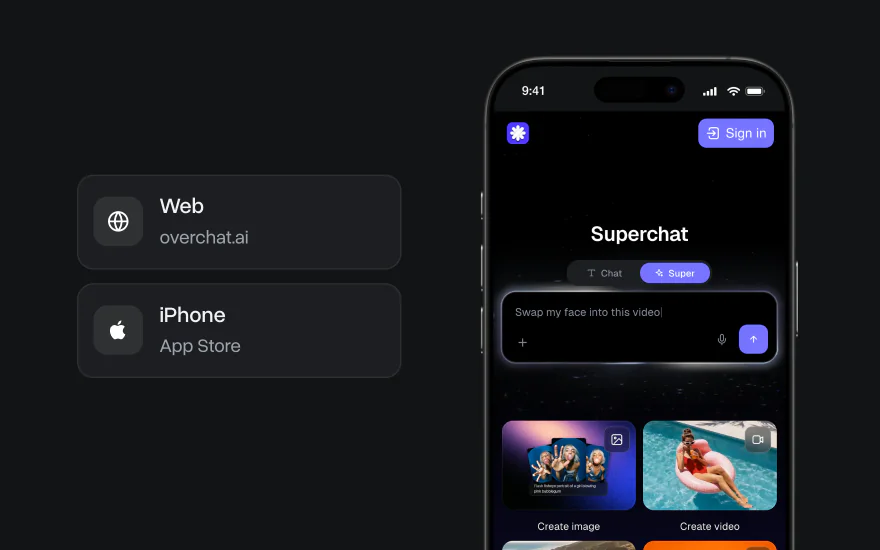
Comece um chat no notebook e termine no celular. O app da Overchat AI tem os mesmos modelos, e seus chats ficam em uma única conta em todos os dispositivos
Modelos Grok na Overchat AI
Compare 2 modelos Grok na Overchat AI por velocidade de saída, tempo até o primeiro token e preço de uma mensagem
Grok 4.7Esta páginaGrok 4.6Fonte: Overchat AI, 2026-11-11
Conheça outros modelos
Os modelos marcados como Em breve estão chegando à Overchat AI; os outros já estão disponíveis


Saiba mais sobre modelos de IA

Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder
Testamos o Gemini 4 Argon contra Claude Opus 5.5, GPT-6 Astra e Muse Wonder em três tarefas de programação. Veja benchmarks, velocidade e como usar
Muse Wonder vs Muse Spark: testamos o novo modelo da Meta
Comparamos o Muse Wonder e o Muse Spark 1.3 em lógica, escrita e programação. Veja benchmarks e qual modelo da Meta é melhor
10 melhores plataformas de IA tudo-em-um em 2026: por que uma assinatura de IA vale mais que várias
Compare as 10 melhores plataformas de IA tudo-em-um em 2026: preços, planos gratuitos e os modelos mais recentes, do Overchat AI ao Poe e ao Krater



